Consensus cria busca acadêmica agêntica em 400M+ fontes acadêmicas com o Zilliz Cloud
400M+
Fontes acadêmicas pesquisáveis
~45 ms
Latência P99 de dense retrieval em produção
14% maior
precisão nos resultados de busca após adicionar a busca semântica
4× maior
vetores por apenas 2,5× o tamanho do cluster, sem penalidade de latência
1 dia → 1 hora
Reindexação completa de toda a coleção de vetores de 400M+ por importação em massa diária
"Nossa função é tornar a melhor pesquisa encontrável para qualquer pessoa que use o Consensus. O Zilliz Cloud proporciona ao nosso agente de pesquisa uma recuperação semântica rápida e de alta qualidade, ampliando diretamente o alcance das evidências que ele pode acessar."
Christian Salem
Sobre a Consensus
A Consensus está construindo o sistema operacional para a pesquisa científica: uma plataforma de agentes usada por mais de 10 milhões de pesquisadores, estudantes e clínicos em 12.500+ universidades para selecionar artigos, sintetizar evidências e automatizar as partes tediosas da pesquisa, para que possam voltar à ciência real. A Consensus já processou mais de 150 milhões de perguntas de pesquisa até hoje e levantou US$ 45 milhões para acelerar os próximos 100 milhões de pesquisadores em todo o mundo.
 Consensus插图1.png
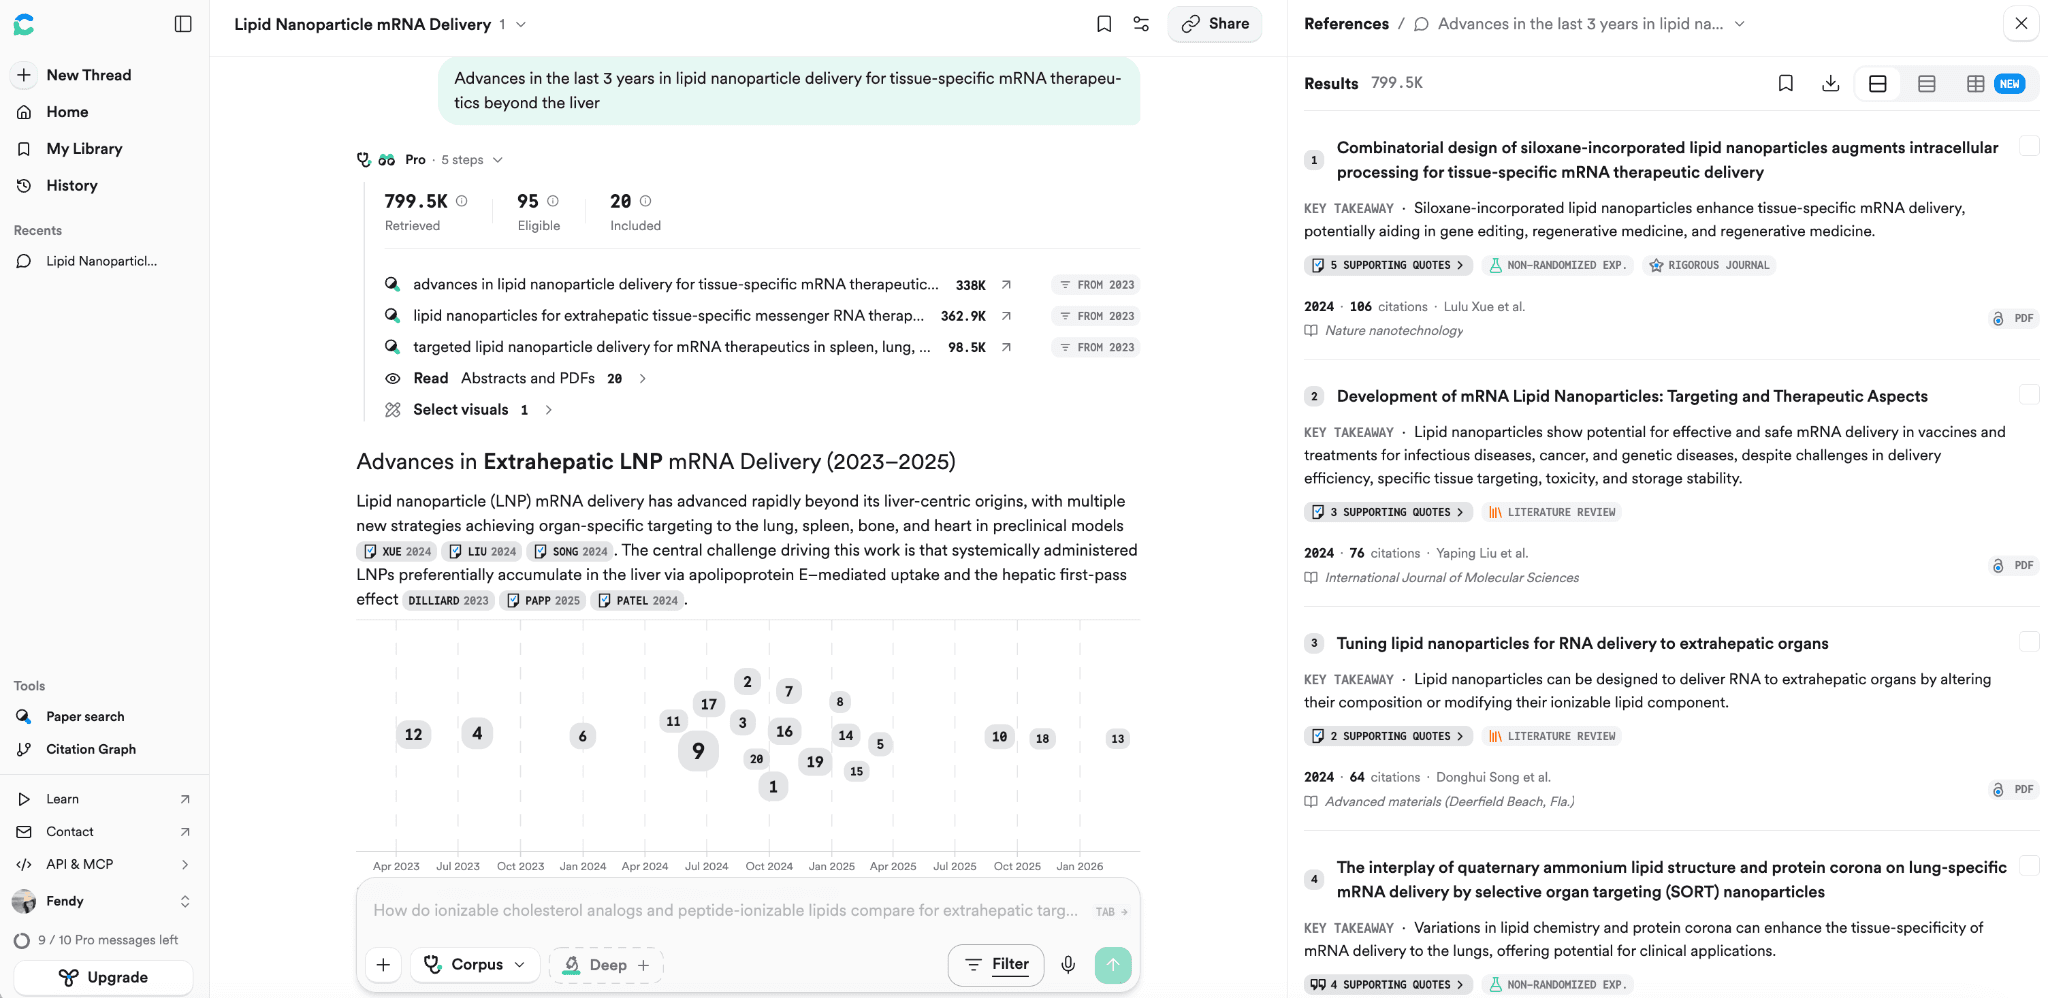
A base da plataforma é uma busca por agentes de classe mundial em mais de 400 milhões de fontes acadêmicas. A Consensus nunca responde com base no conhecimento do próprio modelo de IA; em vez disso, cada afirmação deve remontar a um artigo real recuperado, e o agente de pesquisa pode acionar a recuperação muitas vezes para responder a uma única pergunta. O produto é tão bom quanto os artigos que encontra, o que faz da recuperação o coração da Consensus. A Zilliz Cloud alimenta um de seus componentes mais importantes: a busca semântica que entende o que um pesquisador está realmente perguntando e traz à tona a pesquisa que responde a essa pergunta.
O Desafio
O mecanismo de recuperação da Consensus executava anteriormente dois métodos de recuperação: busca esparsa e busca por palavras-chave BM25. Esses métodos lidavam bem com a maioria das consultas. Mas o nível de exigência estava subindo: a Consensus estava migrando sua revisão de literatura para uma arquitetura baseada em agentes, em que uma pergunta pode se transformar em muitas chamadas de recuperação; assim, a recuperação precisava encontrar os artigos certos e retorná-los rapidamente, a cada chamada. A busca por palavras-chave e a busca esparsa deixam passar artigos que dizem a mesma coisa, mas com terminologia diferente. Os pesquisadores esbarram nisso constantemente, porque o artigo que responde a uma pergunta geralmente vem de uma área vizinha que usa seus próprios termos para a mesma ideia. A busca por vetores densos é fundamental para fechar essa lacuna, então a equipe testou-a primeiro no Elasticsearch e se deparou com mais três problemas.
- A qualidade da recuperação caía com centenas de milhões de vetores. Para comportar tantos vetores densos, a equipe precisava comprimi-los com quantização binária, e a compressão custava uma queda mensurável na qualidade do ranqueamento. Para um produto de pesquisa, esse é o trade-off errado.
- A reindexação de toda a coleção levava mais de 24 horas. Novas pesquisas esperavam um dia ou mais para se tornarem pesquisáveis, e cada modelo de embedding candidato custava um dia inteiro para ser avaliado em produção, o que atrasava a adoção de modelos melhores pela equipe.
- Tornar os vetores maiores significava uma conta de armazenamento muito maior. Com centenas de milhões de vetores, qualquer aumento no tamanho ou na cobertura dos vetores é pago em toda a coleção, então a equipe mantinha os vetores menores do que gostaria.
A equipe foi à procura de um mecanismo feito sob medida para recuperação semântica: alta qualidade de ranqueamento, atualizações rápidas da coleção, viabilidade econômica em escala e uma experiência de produção gerenciada que não exigisse alocação de equipe.
Por que a Zilliz Cloud
A Consensus conduziu um verdadeiro confronto técnico entre quatro opções: busca por vetores densos no Elasticsearch, que ela já havia executado; FAISS, uma biblioteca de vetores open-source auto-hospedada que tinha prototipado; Pinecone; e Zilliz Cloud. A Zilliz Cloud venceu em quatro aspectos.
- Melhores resultados sem comprimir os vetores. Nos próprios testes da equipe, o Zilliz Cloud entregou resultados de recuperação mais precisos na escala de centenas de milhões, mantendo o recall alto, sem a compressão que antes custara qualidade.
- Reconstrução completa da coleção em cerca de uma hora, em vez de mais de um dia. Uma importação diária em massa da coleção inteira transforma a reconstrução completa de um projeto especial em uma tarefa noturna. Isso também permite iteração muito mais rápida ao testar novos modelos de embedding.
- Menor custo de armazenamento para o mesmo tráfego e a mesma quantidade de vetores. A economia permitiu vetores 4 vezes maiores e com até 4x menos custo, resultando em relevância visivelmente maior.
- Um serviço gerenciado, com uma experiência de desenvolvimento que agradou à equipe. A Consensus prototipou com FAISS e o considerou tecnicamente capaz, mas executá-lo em produção significaria arcar com orquestração e sobrecarga operacional que a equipe não tinha interesse em manter. A equipe também achou o SDK do Zilliz Cloud bem documentado e agradável para desenvolver, com um console simples para operações diárias de coleção.
A Solução
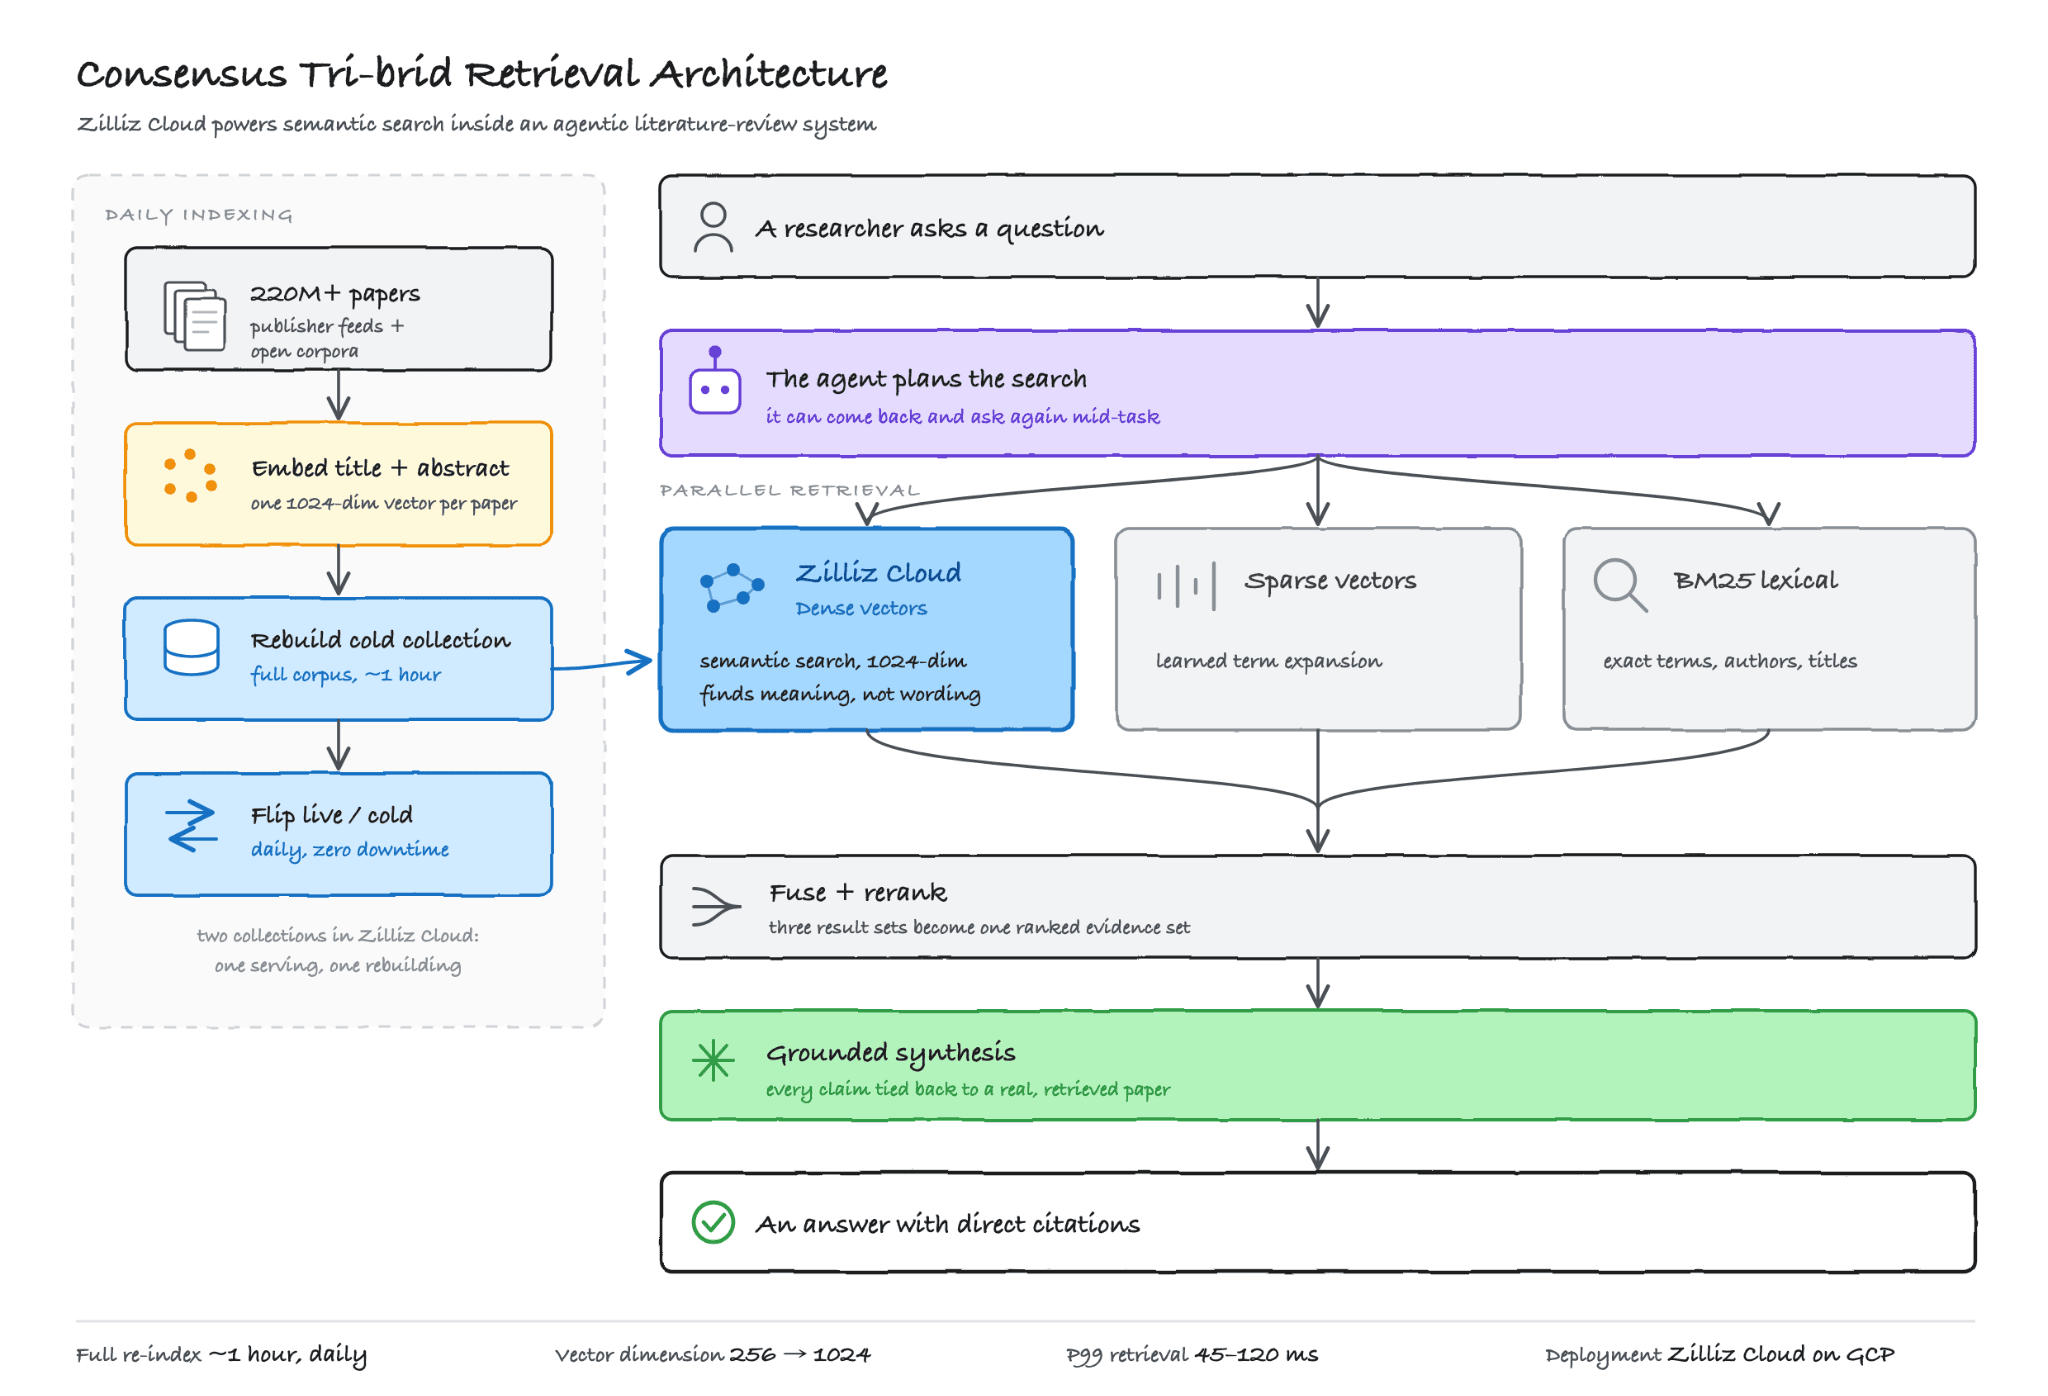
A Consensus responde a uma pergunta de pesquisa recuperando os artigos certos ou partes de artigos e sintetizando uma resposta a partir deles, com cada afirmação citada de volta a uma publicação real. Três caminhos de recuperação são executados em paralelo para encontrar esses artigos, uma arquitetura que a equipe chama de busca tri-brid, e o Zilliz Cloud alimenta a camada de busca semântica: associando uma pergunta a um artigo pelo que ele significa, e não pelas palavras que usa, e encontrando os artigos que os outros caminhos não encontram. Ele roda no Google Cloud junto com o restante da stack.
 Concensus插图2.png
No momento da consulta, o agente planeja a busca e chama a recuperação como uma ferramenta. Os caminhos são executados em paralelo, seus resultados são fundidos e reordenados em um único conjunto de evidências, e o modelo escreve a resposta, vinculando cada afirmação a um artigo recuperado. Essa é a engrenagem por trás do agente de revisão de literatura e do Consensus Meter, que pondera as evidências publicadas a favor e contra uma afirmação.
Três escolhas de design fazem isso funcionar.
Um par de coleções ativo/frio no Zilliz Cloud, reconstruído do zero todos os dias.
A maneira usual de manter um índice desse tamanho atualizado é atualizá-lo in loco: detectar o que mudou, escrever os novos vetores, excluir os antigos e manter a contabilidade em ordem. A Consensus ignora tudo isso. Ela mantém duas cópias da coleção no Zilliz Cloud, mais de 400 milhões de vetores no total, uma servindo consultas e outra ociosa, e todos os dias reconstrói a cópia ociosa do zero por importação em massa e a coloca no ar.
Isso só é um design sensato se uma reconstrução completa for rápida o suficiente para ser executada diariamente e o armazenamento for barato o suficiente para manter uma segunda cópia. No sistema anterior, nada disso era verdade. No Zilliz Cloud, ambos são: a coleção inteira é importada, indexada e pronta para uso em cerca de uma hora, com menor custo de armazenamento. Então o design mais simples vence: nada é nunca gravado na coleção em serviço, não há backlog para reconciliar, e um novo modelo de embeddings é simplesmente a mesma reconstrução com vetores diferentes. O corpus está sempre atualizado, garantindo que os pesquisadores sempre tenham acesso às publicações mais recentes.
"O que a equipe descobriu com a Zilliz é que podemos basicamente reingerir a coleção inteira do zero, porque é muito rápido. Temos duas cópias do índice; ingerimos tudo em uma hora e depois viramos a chave. Neste ponto, podemos fazer isso praticamente todos os dias. Isso também permitiu muito mais experimentação, já que não há hesitação em tentar novas ideias." — Heath Hohwald, Líder Técnico e Gerente de Busca, Consensus
Um vetor de 1.024 dimensões por fonte acadêmica.
Cada fonte é incorporada a partir de seu título e resumo em um único vetor. A equipe começou com 256 dimensões, assumindo que custo e latência cresceriam em conjunto com o tamanho do vetor. No Zilliz Cloud, quadruplicar a dimensão de 256 para 1.024 exigiu cerca de 2,5× o tamanho do cluster, e não os 4× que a equipe esperava, com muito pouca latência adicional. No benchmark interno da equipe, os embeddings de 1.024 dimensões entregaram um aumento de 27% na qualidade dos artigos encontrados em relação ao modelo menor, então a Consensus adotou 1.024.
Busca semântica como ferramenta chamada diretamente pelo agente
O Zilliz Cloud é exposto ao agente de revisão de literatura como uma ferramenta chamável, em vez de oculto atrás de uma única etapa de recuperação. O agente pode reformular a pergunta, buscar de vários ângulos e voltar para mais depois de ler o que encontrou, então uma tarefa pode significar muitas chamadas. Chamadas de ferramenta como essa só funcionam se cada chamada for rápida e precisa, porque uma busca lenta ou imprecisa é multiplicada por cada chamada extra que o agente faz. Com ~45 ms de P99 em 400M+ vetores, a busca semântica é rápida e precisa o suficiente para ser entregue ao agente como ferramenta, para que ele possa perseguir os últimos artigos difíceis de encontrar que uma única consulta deixaria passar.
Resultados e Benefícios
- Custo de armazenamento até 4× menor, e a economia foi direcionada para uma busca melhor. O armazenamento custa menos com o mesmo tráfego e a mesma contagem de vetores, criando a folga que a equipe depois investiu em qualidade.
- Precisão 14% maior nos resultados de busca após a adição da busca semântica, medida no benchmark interno da própria Consensus. O ganho é mais forte em artigos que respondem a uma pergunta com palavras que o pesquisador nunca usou, algo que a stack anterior teria deixado passar.
- P99 de recuperação em ~45 ms em 400M+ vetores, um terço da meta de P90 de 150 ms que a equipe definiu para o Zilliz Cloud. Rápido o suficiente para o agente de pesquisa buscar, refletir e iterar várias vezes em uma única solicitação, em vez de ter apenas uma chance e às vezes perder resultados críticos.
- Dimensões de vetor 4x maiores (256 → 1.024) custam apenas 2,5× o cluster no Zilliz Cloud, cerca de 40% menos que o escalonamento linear, sem penalidade de latência. No benchmark interno da Consensus, os embeddings maiores proporcionaram um aumento de 27% na qualidade dos artigos encontrados.
- Reconstrução completa de toda a coleção: 24+ horas → cerca de 1 hora, como uma importação em massa diária. A Consensus agora reconstrói e troca toda a coleção diariamente, sem interrupção do serviço. Novas pesquisas ficam pesquisáveis no dia em que são publicadas.
- O ciclo de iteração fica mais rápido. Embeddings maiores, novos modelos e novas estratégias de recuperação não precisam mais ser avaliados em comparação com uma reconstrução de um dia inteiro antes que alguém possa ver se eles ajudam.
O Que Vem a Seguir
Todas as direções para as quais a Consensus está caminhando colocam mais peso no Zilliz Cloud. Expor a busca semântica de forma mais ampla por meio do framework agêntico significa mais chamadas de recuperação por tarefa e mais tráfego contra a coleção densa. Novos modelos de embedding continuarão sendo lançados no ritmo diário que a reconstrução de uma hora torna possível. A filtragem por metadados, atualmente tratada na camada de aplicação, é candidata a migrar para o Zilliz Cloud.
A maior oportunidade é alavancar ainda mais o conteúdo de texto completo. A Consensus detém conteúdo licenciado de texto completo por meio de suas parcerias com editoras, e levar essa profundidade para a coleção densa do Zilliz é um próximo passo natural: indexar o corpo de cada artigo em vez de seu título e resumo multiplicaria a coleção várias vezes e daria aos pesquisadores uma correspondência muito mais granular.
"A Consensus está fazendo algo genuinamente difícil: tornar a literatura científica mundial pesquisável por significado, para um agente que pode perguntar ao mesmo corpus de uma dúzia de maneiras diferentes em uma única tarefa. Temos orgulho de que o Zilliz Cloud seja a base de recuperação por trás disso, e estamos animados para continuar construindo juntos à medida que a pesquisa agêntica escala." — James Luan, CTO da Zilliz
Construa IA Agêntica com o Zilliz Cloud
Sistemas de agentes colocam nova pressão sobre a recuperação: uma solicitação do usuário pode se transformar em várias buscas semânticas, reformulações e etapas de coleta de evidências. Esteja você escalando RAG ou construindo busca baseada em agentes, o Zilliz Cloud oferece a mesma base de recuperação que potencializa o Consensus.
Comece a usar o Zilliz Cloud gratuitamente, ou fale com nossa equipe diretamente.
"Uma das maiores vitórias que vimos foi o melhor tratamento de consultas que são semanticamente, mas não textualmente, relevantes. Consultas mais longas e mais conversacionais também melhoraram drasticamente."
Heath Hohwald