




Executando Llama 3, Mixtral e GPT-4o
Há muitas maneiras diferentes de executar a parte de Geração (G) do RAG! Hoje vou mostrar algumas formas de executar alguns dos concorrentes mais quentes neste espaço: Llama 3 da Meta, Mixtral da Mistral e o recém-anunciado GPT-4o da OpenAI.
Como podemos ver no LMSYS Leaderboard abaixo, a diferença (em azul-claro) entre modelos de código fechado e modelos de código aberto acabou de sofrer um aumento nesta semana com o novo anúncio da OpenAI.
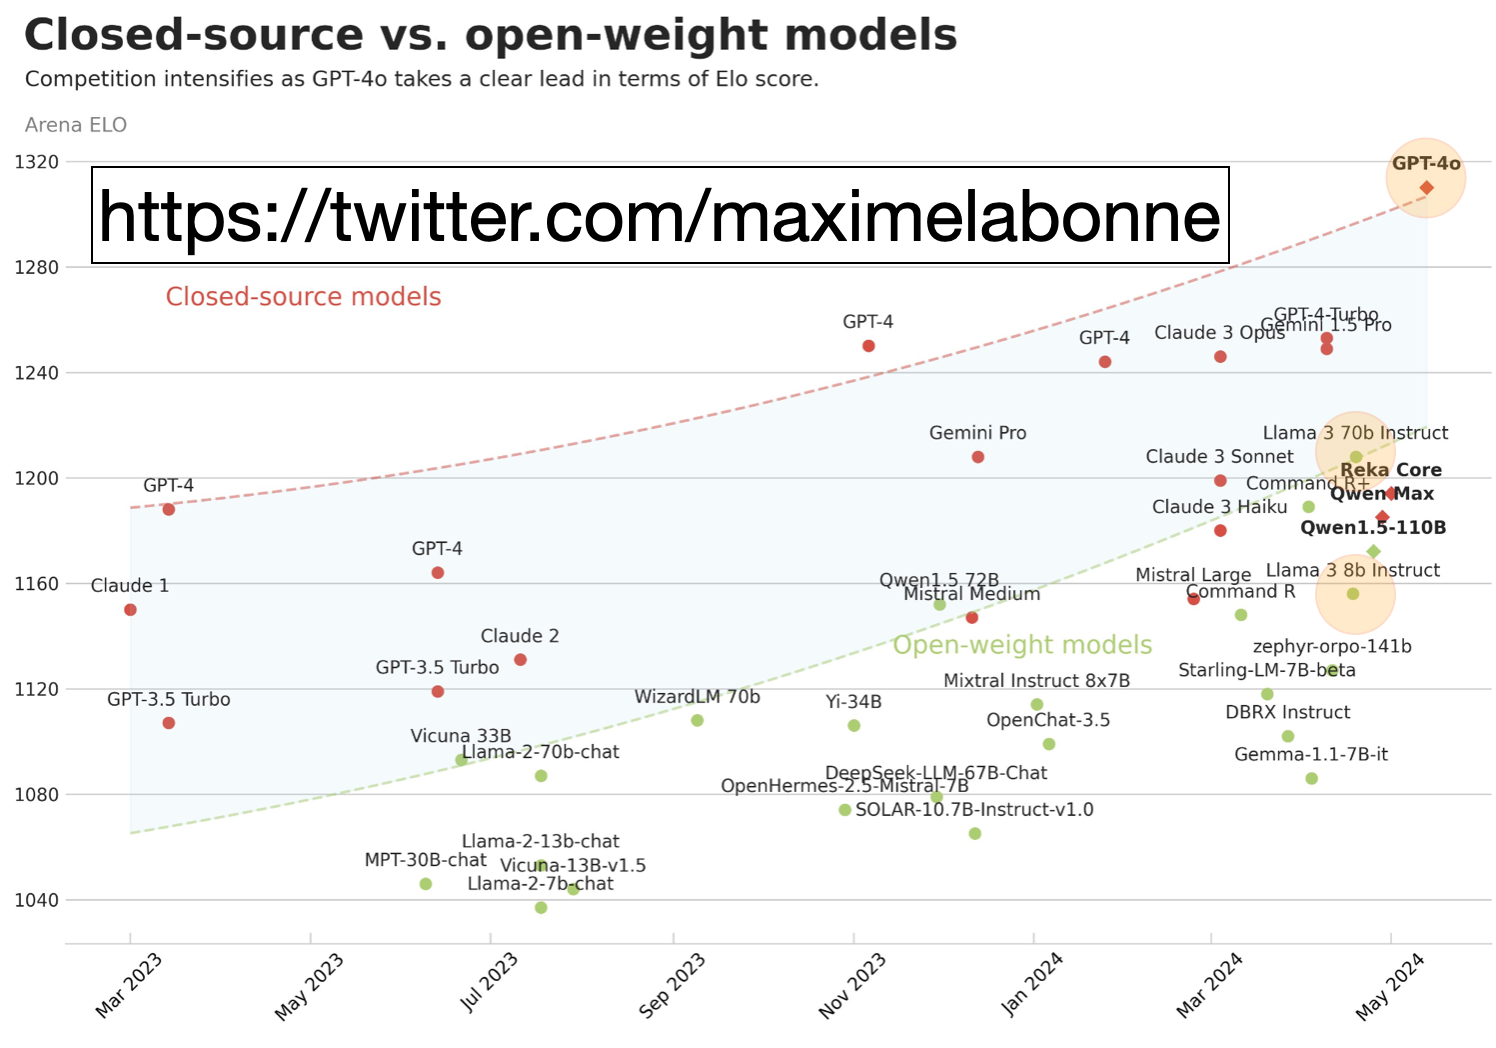 código fechado vs aberto
Fonte da imagem: https://twitter.com/maximelabonne com base em https://chat.lmsys.org/?leaderboard.
Esboço deste blog:
As maneiras mais rápidas de executar Llama 3 ou Mixtral de código aberto
Localmente com Ollama
Endpoints da Anyscale
Endpoint da OctoAI
Endpoint da Groq
Execute o mais recente gpt-4o da OpenAI
Avalie respostas: GPT-4o, Llama 3, Mixtral
Vamos começar!
Execute o Llama 3 localmente usando Ollama
Primeiro, execute RAG da maneira usual, até a última etapa, onde você gera a resposta, a parte G do RAG. Temos muitos tutoriais para começar com RAG, incluindo este em Python.
Para executar o Llama 3 localmente usando Ollama.
Siga as instruções para instalar o ollama e baixar um modelo.
Essa página diz que
ollama run llama3baixará por padrão o modelo "instruct" mais recente, que é ajustado para casos de uso de chat/diálogo E cabe no seu computador. Execute esse comando.Para Python,
pip install ollama.No seu código Python de RAG, defina um Prompt e uma Pergunta, e invoque a chamada de API para o seu modelo Llama 3 instalado localmente.
No meu caso, tenho um laptop M2 com 16GB, então o modelo Ollama baixado é a versão gguf compilada com a maior quantização do Llama3-8B. Ou seja, uma versão muito pequena do Llama 3 agora está instalada no meu laptop!
# Separate all the context together by space, reverse order.
# See “Lost in the middle” arxiv.org paper.
contexts_combined = ' '.join(reversed(contexts))
source_combined = ' '.join(reversed(sources))

# Define a Prompt.
SYSTEM_PROMPT = f"""Given the provided Context, your task is to
understand the content and accurately answer the question based
on the information available in the context.
Provide a complete, clear, concise, relevant response in fewer
than 4 sentences and cite the unique Sources.
Answer: The answer to the question.
Sources: {source_combined}
Context: {contexts_combined}
"""

# Send the Question and Prompt to local! llama 3 chat.
import ollama
start_time = time.time()
response = ollama.chat(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model='llama3',
   stream=False,
   options={"temperature": TEMPERATURE, "seed": RANDOM_SEED,
            "top_p": TOP_P,
           #  "max_tokens": MAX_TOKENS, # not recognized
            "frequency_penalty": FREQUENCY_PENALTY}
)

ollama_llama3_time = time.time() - start_time
pprint.pprint(response['message']['content'].replace('\n', ' '))
print(f"ollama_llama3_time: {format(ollama_llama3_time, '.2f')} seconds")
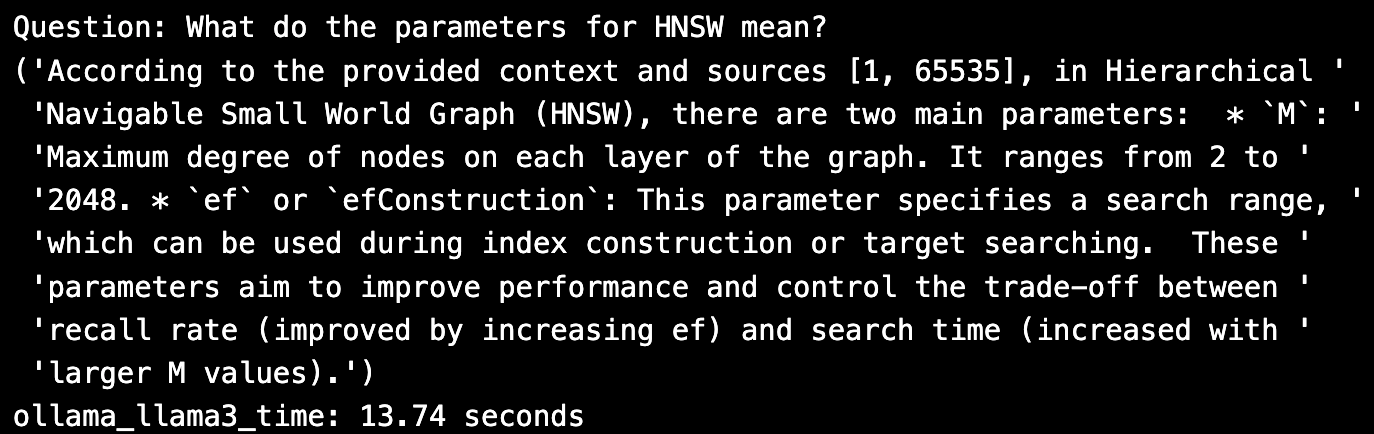
A resposta parece muito boa; vejo três parâmetros, mas apenas a citação parece truncada. O modelo local levou 13 segundos para executar a inferência no meu laptop, mas o custo foi gratuito.
Execute o Llama 3 a partir de endpoints da Anyscale
Para executar a inferência do Llama 3 a partir de endpoints da Anyscale:
Siga as instruções na página do github dos endpoints da Anyscale para instalar a linha de comando e depois instalar o plugin.
Obtenha seu token de API do endpoint Anysclae e atualize suas variáveis de ambiente.
Para Python,
pip install openai.Leia sobre o modelo Llama 3 baixado do HuggingFace e invoque-o usando a API da OpenAI. Eu usei o Llama 3 padrão no playground da Anyscale, que era um modelo 70B-Instruct.
import openai

LLM_NAME = "meta-llama/Llama-3-70b-chat-hf"

anyscale_client = openai.OpenAI(
   base_url = "https://api.endpoints.anyscale.com/v1",
   api_key=os.environ.get("ANYSCALE_ENPOINT_KEY"),
)

start_time = time.time()
response = anyscale_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_anyscale_endpoints_time = time.time() - start_time

# Print the response.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_anyscale_endpoints_time: {format(llama3_anyscale_endpoints_time, '.2f')} seconds")
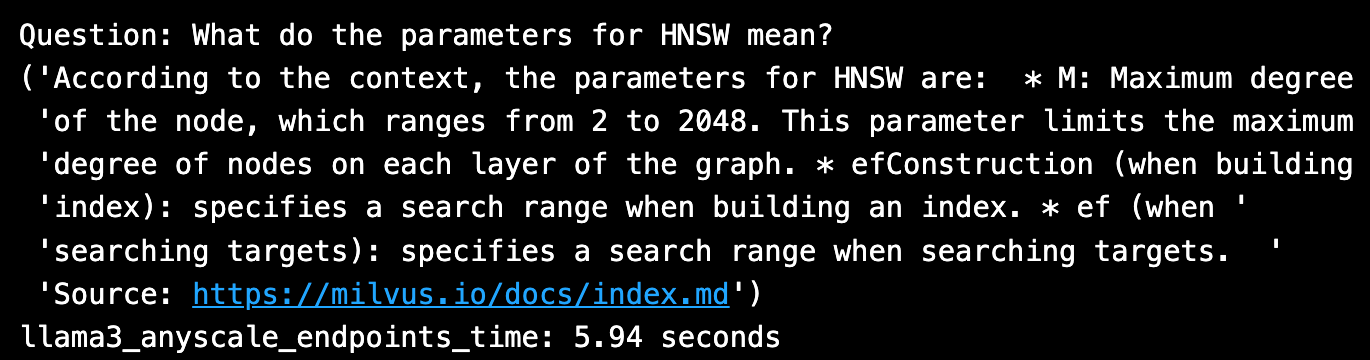
A resposta parece boa, incluindo uma citação perfeita. O HuggingFace Llama 3 70B levou ~6 segundos para ser invocado a partir dos endpoints da Anyscale.
Execute o Llama 3 a partir dos Endpoints da OctoAI
Para executar a inferência do Llama 3 a partir dos endpoints da OctoAI:
Acesse https://octoai.cloud/text, escolha o modelo Llama 3 8B, clique no link do modelo e você verá um código de exemplo.
Obtenha seu token de API do endpoint da OctoAI e atualize suas variáveis de ambiente.
Para Python,
pip install octoai.Leia sobre o modelo Llama 3 8B baixado da Meta e invoque-o.
from octoai.text_gen import ChatMessage
from octoai.client import OctoAI

LLM_NAME = "meta-llama-3-70b-instruct"

octoai_client = OctoAI(
   api_key=os.environ.get("OCTOAI_TOKEN"),
)

start_time = time.time()
response = octoai_client.text_gen.create_chat_completion(
   messages=[
       ChatMessage(
           content=SYSTEM_PROMPT,
           role="system"
       ),
       ChatMessage(
           content=SAMPLE_QUESTION,
           role="user"
       )
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   # seed=RANDOM_SEED, # not recognized
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_octai_endpoints_time = time.time() - start_time

# Print the response.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_octai_endpoints_time: {format(llama3_octai_endpoints_time, '.2f')} seconds")
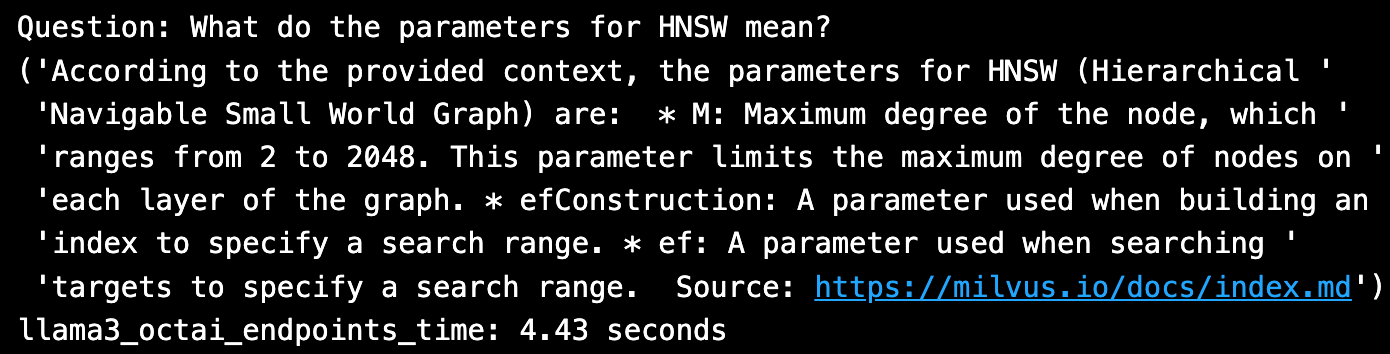
A resposta parece boa e a citação é perfeita. O Llama 3 70B levou menos de ~4 segundos para ser invocado a partir dos endpoints da OctoAI.
Execute o Llama 3 a partir dos endpoints Groq LPU
Para executar a inferência do Llama 3 a partir dos endpoints da Groq:
Acesse console.groq.com e siga as instruções.
Obtenha seu token de API do endpoint da Groq e atualize suas variáveis de ambiente.
Para Python,
pip install groq.Leia sobre o modelo Llama 3 8B baixado do HuggingFace e invoque-o.
from groq import Groq

LLM_NAME = "llama3-70b-8192"

groq_client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

start_time = time.time()
response = groq_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
llama3_groq_endpoints_time = time.time() - start_time

# Imprima a resposta.
pprint.pprint(response.choices[0].message.content.replace('\n', ' '))
print(f"llama3_groq_endpoints_time: {format(llama3_groq_endpoints_time, '.2f')} segundos")
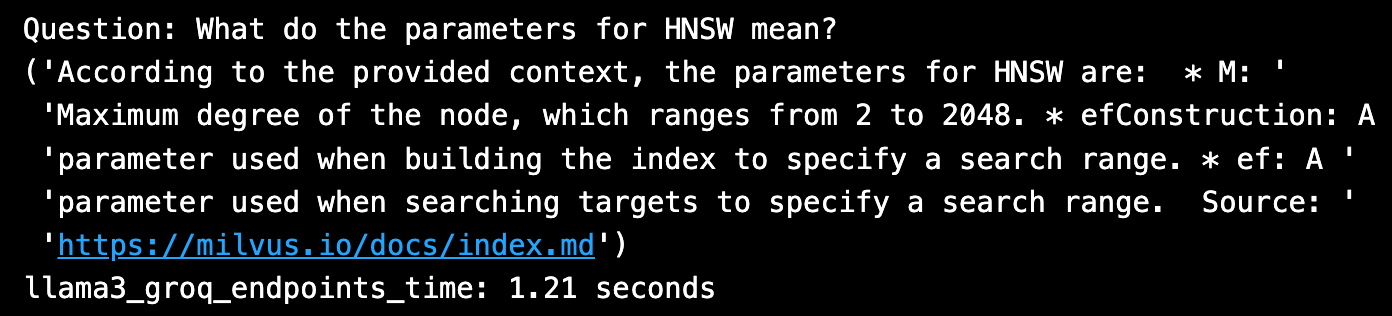
A resposta parece um pouco mais sucinta, e a citação está perfeita. O Llama 3 20B levou ~1 segundo para ser invocado a partir dos endpoints Groq LPU, que é a inferência mais rápida até agora!
Observação - para executar o Mixtral, siga todos os mesmos passos, apenas altere LLM_NAME para o nome usado por cada Endpoint Platform para o modelo Mixtral.
Execute o GPT-4o da OpenAI
Para executar a inferência mais recente do GPT-4o da OpenAI:
Obtenha seu token de API da OpenAI e atualize suas variáveis de ambiente.
Siga as instruções sobre como chamar o novo modelo.
Para Python,
pip install --upgrade openai --quiet.Leia sobre o novo modelo GPT-4o e invoque-o.
import openai, pprint
from openai import OpenAI

LLM_NAME = "gpt-4o" # "gpt-3.5-turbo"

openai_client = OpenAI(
   # This is the default and can be omitted
   api_key=os.environ.get("OPENAI_API_KEY"),
)

start_time = time.time()
response = openai_client.chat.completions.create(
   messages=[
       {"role": "system", "content": SYSTEM_PROMPT,},
       {"role": "user", "content": f"question: {SAMPLE_QUESTION}",}
   ],
   model=LLM_NAME,
   temperature=TEMPERATURE,
   seed=RANDOM_SEED,
   frequency_penalty=FREQUENCY_PENALTY,
   top_p=TOP_P,
   max_tokens=MAX_TOKENS,
)
chatgpt_4o_turbo_time = time.time() - start_time

# Print the question and answer along with grounding sources and citations.
print(f"Question: {SAMPLE_QUESTION}")
for i, choice in enumerate(response.choices, 1):
   message = choice.message.content.replace('\n', '')
   pprint.pprint(f"Answer: {message}")
print(f"chatgpt_4o_turbo_time: {format(chatgpt_4o_turbo_time, '.5f')}")
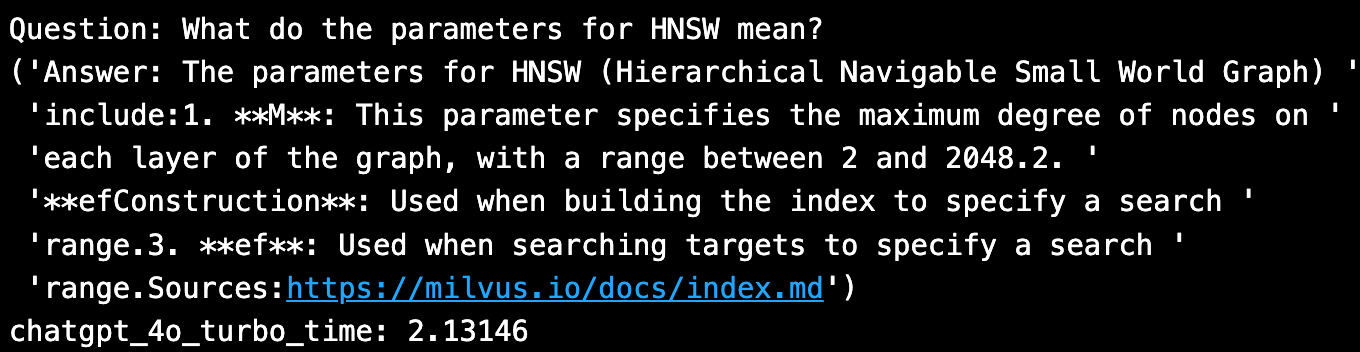
O novo modelo GPT-4o parece bom e inclui uma citação da fonte de fundamentação. Levou 2 segundos para executar a inferência.
Avaliação Rápida de Respostas usando Ragas
Eu explico em este blog como usar o Ragas open source para avaliar sistemas RAG. Estou usando apenas uma P&R abaixo. Uma avaliação mais realista usaria ~20 perguntas.
import os, sys
import pandas as pd
import numpy as np
import ragas, datasets
from langchain_community.embeddings import HuggingFaceEmbeddings
from ragas.embeddings import LangchainEmbeddingsWrapper

from ragas.metrics import (
   # context_recall,
   # context_precision,
   # faithfulness,
   answer_relevancy,
   answer_similarity,
   answer_correctness
   )

# Read ground truth answers from file.
eval_df = pd.read_csv(file_path, header=0, skip_blank_lines=True)

# Possible LLM model choices to evaluate:
# openai gpt-4o = 'Custom_RAG_answer'
LLM_TO_EVALUATE = 'Custom_RAG_answer'
# LLM_TO_EVALUATE = 'llama3_ollama_answer'
# LLM_TO_EVALUATE = 'llama3_anyscale_answer'
# LLM_TO_EVALUATE = 'llama3_octoai_answer'
# LLM_TO_EVALUATE = 'llama3_groq_answer'
# LLM_TO_EVALUATE = 'mixtral_8x7b_anyscale_answer'

CONTEXT_TO_EVALUATE='Custom_RAG_context'
eval_metrics=[
    answer_relevancy,
    answer_similarity,
    answer_correctness,]
metrics = ['answer_relevancy', 'answer_similarity', 'answer_correctness']

# Change the default llm-as-critic, to save $.
LLM_NAME = "gpt-3.5-turbo"
ragas_llm = ragas.llms.llm_factory(model=LLM_NAME)

# Change the default embeddings to HuggingFace models.
EMB_NAME = "BAAI/bge-large-en-v1.5"
lc_embeddings = HuggingFaceEmbeddings(model_name=EMB_NAME)
ragas_emb = LangchainEmbeddingsWrapper(embeddings=lc_embeddings)

# Altere cada métrica.
for metric in metrics:
   globals()[metric].llm = ragas_llm
   globals()[metric].embeddings = ragas_emb

# Execute a avaliação.
ragas_result, score = _eval_ragas.evaluate_ragas_model(
   eval_df, eval_metrics, LLM_TO_EVALUATE,
   CONTEXT_TO_EVALUATE, EVALUATE_WHAT)

# Exiba os resultados.
print(f"Using {eval_df.shape[0]} eval questions, Mean Score = {score}")
display(ragas_result.head())
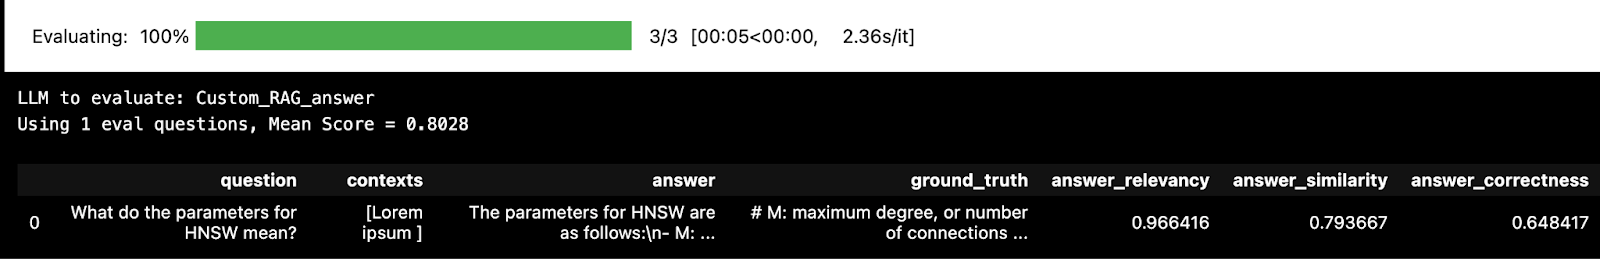
Abaixo está uma tabela que resume os resultados.
| Endpoint do modelo | Resposta | Latência (segundos) | Custo | Pontuação de Resposta Ragas |
Ollama Llama 3 | De acordo com o contexto e as fontes fornecidos [1, 65535], no Hierarchical Navigable Small World Graph (HNSW), há dois parâmetros principais: * `M`: Grau máximo dos nós em cada camada do grafo. Ele varia de 2 a 2048. * `ef` ou `efConstruction`: Este parâmetro especifica um intervalo de busca, que pode ser usado durante a construção do índice ou a busca de alvos. Esses parâmetros visam melhorar o desempenho e controlar o equilíbrio entre a taxa de recall (melhorada ao aumentar ef) e o tempo de busca (aumentado com valores maiores de M). | 13.74 | Gratuito | 0.76 |
Anyscale endpoints Llama 3 | `De acordo com o contexto, os parâmetros para HNSW são: * M: Grau máximo do nó, que varia de 2 a 2048. Este parâmetro limita o grau máximo dos nós em cada camada do grafo. * efConstruction (ao construir o índice): especifica um intervalo de busca ao construir um índice. * ef (ao buscar alvos): especifica um intervalo de busca ao buscar alvos. | |||
Fonte:[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md)'` | 5.94 | Playground gratuito | 0.80 | |
Anyscale Mixtral | `O parâmetro M para HNSW refere-se ao grau máximo do nó, que é o número máximo de conexões que um nó pode ter na estrutura do grafo. Ele varia de 2 a 2048. Além disso, efConstruction e ef são parâmetros usados para especificar o intervalo de busca durante a construção do índice e a busca de alvos, respectivamente. | |||
Fontes: 1.[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md) 2. [https://milvus.io/docs/index.md](https://milvus.io/docs/index.md)'` | 3.57 | Playground gratuito | 0.79 | |
OctoAI Llama 3 | `De acordo com o contexto fornecido, os parâmetros para HNSW (Hierarchical Navigable Small World Graph) são: * M: Grau máximo do nó, que varia de 2 a 2048. Este parâmetro limita o grau máximo dos nós em cada camada do grafo. * efConstruction: Um parâmetro usado ao construir um índice para especificar um intervalo de busca. * ef: Um parâmetro usado ao buscar alvos para especificar um intervalo de busca. | |||
Fonte:[ https://milvus.io/docs/index.md](https://milvus.io/docs/index.md) ` | 4.43 | $0.15 por milhão de tokens | 0.73 | |
Groq Llama 3 | `De acordo com o contexto fornecido, os parâmetros para HNSW são: * M: Grau máximo do nó, que varia de 2 a 2048. * efConstruction: Um parâmetro usado ao construir o índice para especificar um intervalo de busca. * ef: Um parâmetro usado ao buscar alvos para especificar um intervalo de busca. | |||
Fonte: [https://milvus.io/docs/index.md`](https://milvus.io/docs/index.md) | 1.21 | `Gratuito | ||
| beta` | 0.79 | |||
Openai gpt-4o | Os parâmetros para HNSW são os seguintes:``- M: Grau máximo do nó, limitando as conexões que cada nó pode ter no grafo. O intervalo é [2, 2048].``- efConstruction: Parâmetro usado durante a construção do índice para especificar um intervalo de busca.``- ef: Parâmetro usado ao buscar alvos para especificar um intervalo de busca.``Fontes:https://milvus.io/docs/index.md | 2.13 | `$5/M entrada | |
| $15/M saída` | 0.803 |
Fonte: Código do autor e https://console.anyscale.com/v2/playground, https://console.groq.com/playground?model=llama3-70b-8192, https://octoai.cloud/text?selectedTags=Chat, https://openai.com/api/pricing/.
Conclusão
Hoje, temos muitas opções de modelos e endpoints de inferência para escolher para a parte de G-Geração do RAG! Todos os endpoints testados neste blog têm qualidade de resposta variável (conforme avaliada por um crítico-GPT), latências e custos a considerar.
Continue lendo
Introducing Zilliz CLI and Agent Skills for Zilliz Cloud
Manage your vector database from your terminal or AI coding agent. Zilliz CLI and Agent Skills work with Claude Code, Cursor, Codex, and Copilot.
Introducing Customer-Managed Encryption Keys (CMEK) on Zilliz Cloud
We're announcing the general availability of Customer-Managed Encryption Keys (CMEK) on Zilliz Cloud.
DeepSeek-VL2: Mixture-of-Experts Vision-Language Models for Advanced Multimodal Understanding
Explore DeepSeek-VL2, the open-source MoE vision-language model. Discover its architecture, efficient training pipeline, and top-tier performance.