




Construindo um Sistema de QA Inteligente com NLP e Milvus
Projeto Milvus:github.com/milvus-io/milvus
O sistema de resposta a perguntas é comumente usado no campo do processamento de linguagem natural. Ele é usado para responder a perguntas na forma de linguagem natural e tem uma ampla gama de aplicações. Aplicações típicas incluem: interação por voz inteligente, atendimento ao cliente online, aquisição de conhecimento, bate-papo emocional personalizado e muito mais. A maioria dos sistemas de resposta a perguntas pode ser classificada como: sistemas de resposta a perguntas generativos e de recuperação, sistemas de resposta a perguntas de rodada única e de múltiplas rodadas, sistemas de resposta a perguntas abertos e sistemas de resposta a perguntas específicos.
Este artigo trata principalmente de um sistema de QA projetado para um campo específico, que geralmente é chamado de robô inteligente de atendimento ao cliente. No passado, criar um robô de atendimento ao cliente geralmente exigia a conversão do conhecimento do domínio em uma série de regras e grafos de conhecimento. O processo de construção depende muito da inteligência “humana”. Uma vez que os cenários mudavam, muito trabalho repetitivo seria necessário. Com a aplicação do deep learning no processamento de linguagem natural (NLP), a leitura automática pode encontrar automaticamente respostas para perguntas correspondentes diretamente em documentos. O modelo de linguagem de deep learning converte as perguntas e documentos em vetores semânticos para encontrar a resposta correspondente.
Este artigo usa o modelo BERT de código aberto do Google e o Milvus, um mecanismo de busca vetorial de código aberto, para criar rapidamente um bot de perguntas e respostas baseado em compreensão semântica.
Arquitetura geral
Este artigo implementa um sistema de resposta a perguntas por meio de correspondência de similaridade semântica. O processo geral de construção é o seguinte:
- Obter um grande número de perguntas com respostas em um campo específico (um conjunto padrão de perguntas).
- Usar o modelo BERT para converter essas perguntas em vetores de características e armazená-los no Milvus. E o Milvus atribuirá um ID de vetor a cada vetor de características ao mesmo tempo.
- Armazenar esses IDs de perguntas representativas e suas respostas correspondentes no PostgreSQL.
Quando um usuário faz uma pergunta:
- O modelo BERT a converte em um vetor de características.
- O Milvus realiza uma busca por similaridade e recupera o ID mais semelhante à pergunta.
- O PostgreSQL retorna a resposta correspondente.
O diagrama da arquitetura do sistema é o seguinte (as linhas azuis representam o processo de importação e as linhas amarelas representam o processo de consulta):
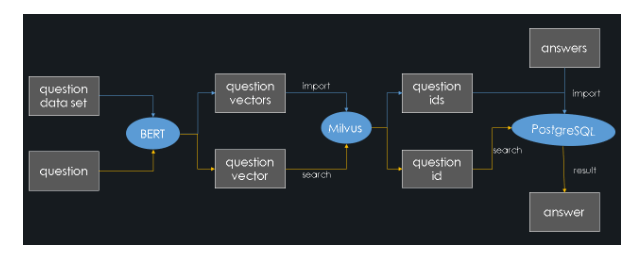 Figura 1.
A seguir, mostraremos como criar um sistema de perguntas e respostas online passo a passo.
Etapas para criar o sistema de perguntas e respostas
Antes de começar, você precisa instalar o Milvus e o PostgreSQL. Para as etapas específicas de instalação, consulte o site oficial do Milvus.
1. Preparação dos dados
Os dados experimentais neste artigo vêm de: https://github.com/chatopera/insuranceqa-corpus-zh
O conjunto de dados contém pares de dados de perguntas e respostas relacionados ao setor de seguros. Neste artigo, extraímos 20.000 pares de perguntas e respostas dele. Por meio deste conjunto de dados de perguntas e respostas, você pode criar rapidamente um robô de atendimento ao cliente para o setor de seguros.
2. Gerar vetores de características
Este sistema usa um modelo que o BERT pré-treinou. Baixe-o no link abaixo antes de iniciar um serviço: https://storage.googleapis.com/bert_models/2018_10_18/cased_L-24_H-1024_A-16.zip
Use este modelo para converter o banco de dados de perguntas em vetores de características para busca por similaridade futura. Para mais informações sobre o serviço BERT, consulte https://github.com/hanxiao/bert-as-service.
 Figura 2.
3. Importar para o Milvus e PostgreSQL
Normalize e importe os vetores de características gerados para o Milvus e, em seguida, importe os IDs retornados pelo Milvus e as respostas correspondentes para o PostgreSQL. A seguir é mostrada a estrutura da tabela no PostgreSQL:
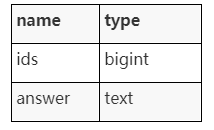 Figura 3.
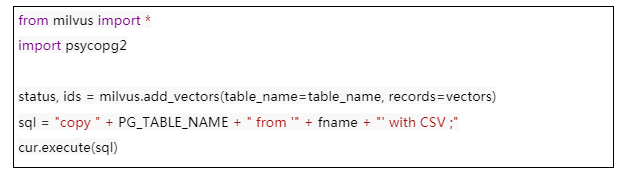 Figura 4.
4. Recuperar respostas
O usuário insere uma pergunta e, após gerar o vetor de características por meio do BERT, pode encontrar a pergunta mais semelhante na biblioteca Milvus. Este artigo usa a distância de cosseno para representar a similaridade entre duas frases. Como todos os vetores são normalizados, quanto mais próxima de 1 estiver a distância de cosseno dos dois vetores de características, maior será a similaridade.
Na prática, seu sistema pode não ter perguntas perfeitamente correspondentes na biblioteca. Então, você pode definir um limite de 0,9. Se a maior distância de similaridade recuperada for menor que esse limite, o sistema indicará que não inclui perguntas relacionadas.
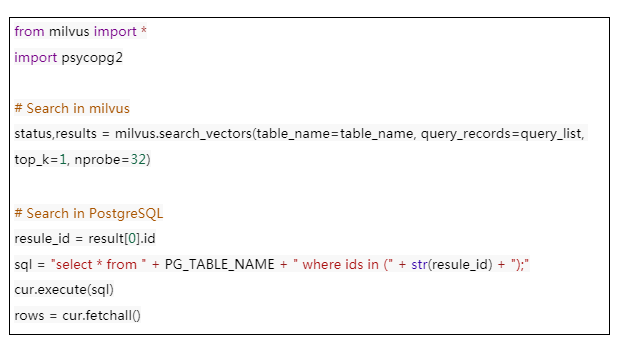 Figura 5.
Demonstração do sistema
A seguir, é mostrada uma interface de exemplo do sistema:
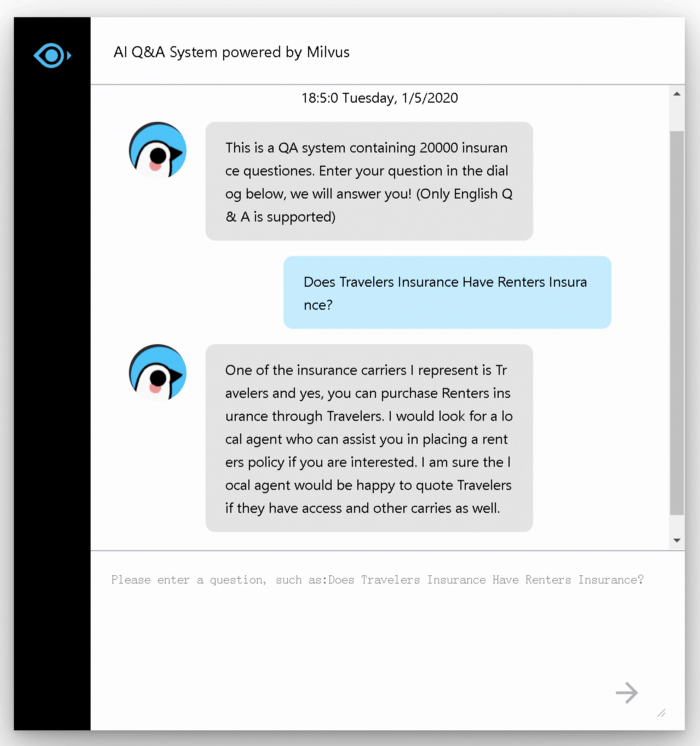 Figura 6.
Insira sua pergunta na caixa de diálogo e você receberá uma resposta correspondente:
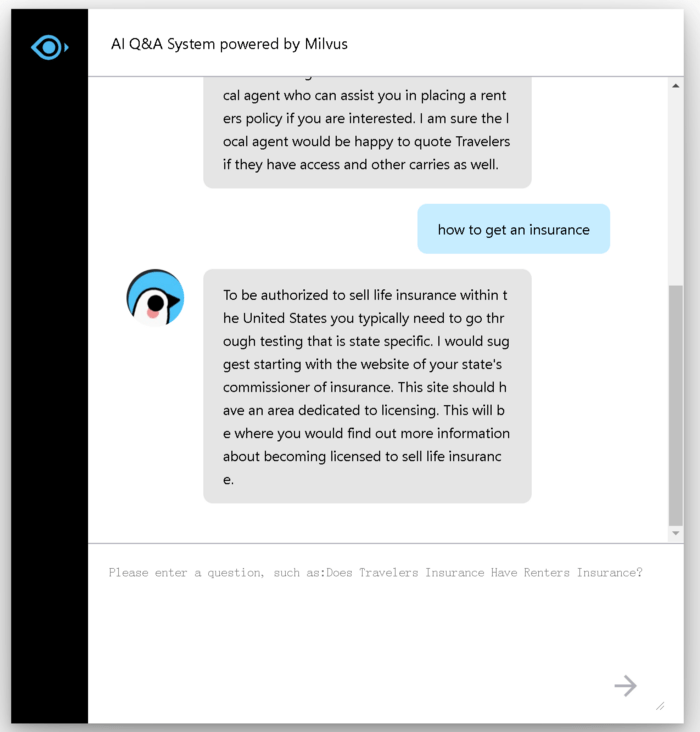 Figura 7.
Resumo
Após ler este artigo, esperamos que você ache fácil criar seu próprio sistema de perguntas e respostas.
Com o modelo BERT, você não precisa mais classificar e organizar os corpora de texto antecipadamente. Ao mesmo tempo, graças ao alto desempenho e à alta escalabilidade do mecanismo de busca vetorial de código aberto Milvus, seu sistema de QA pode oferecer suporte a um corpus de até centenas de milhões de textos.
Milvus juntou-se oficialmente à Linux AI (LF AI) Foundation para incubação. Você é bem-vindo para participar da comunidade Milvus e trabalhar conosco para acelerar a aplicação de tecnologias de IA!
=> Experimente nossa demonstração online aqui: https://www.milvus.io/scenarios
Continue lendo
How to Migrate from Chroma to Zilliz Cloud
Chroma Cloud goes read-only on November 22. Move your collections to Zilliz Cloud, from Chroma Cloud or self-hosted Chroma, and update your app.
Introducing Customer-Managed Encryption Keys (CMEK) on Zilliz Cloud
We're announcing the general availability of Customer-Managed Encryption Keys (CMEK) on Zilliz Cloud.
Introducing DeepSearcher: A Local Open Source Deep Research
In contrast to OpenAI’s Deep Research, this example ran locally, using only open-source models and tools like Milvus and LangChain.