




Alexandr Guzhva: Por que me juntei à Zilliz
Meu nome é Alexandr Guzhva e trabalho na Zilliz com otimização de desempenho.
Entrei na Zilliz para superar os concorrentes da empresa. E porque senti que poderia usar plenamente minha expertise.
Passei 15 anos no setor financeiro, onde comecei a usar a abordagem de busca aproximada pelo vizinho mais próximo (ANNS) para acelerar previsões de séries temporais para simulação de algo trading, tanto em CPU quanto em GPU. O mecanismo de computação que criei conseguia realizar simulações várias ordens de magnitude mais rápido do que a linha de base, graças à ANNS.
Depois disso, passei cerca de 2 anos na Meta, onde adicionei código relacionado a desempenho à biblioteca FAISS e usei seus poderosos recursos para aplicar codecs vetoriais na compressão de enormes modelos de recomendação que a Meta usa para Ads. Passei a ser considerado um dos autores da biblioteca FAISS por causa das minhas contribuições de código.
No total, escrevi mais de 2 milhões de linhas de código durante minha carreira e venho lidando com métodos de busca por similaridade há 10 anos.
A Zilliz como empresa se tornou interessante para mim, porque eu sabia que ela usa várias maneiras de acelerar seus produtos, como uma integração com NVIDIA Raft, experimentos com várias plataformas de hardware e métodos avançados de busca por similaridade. Isso me deu a confiança de que as atividades de engenharia e pesquisa necessárias são bastante não triviais, não no estilo python-monkey :) Muitas empresas a utilizam, o que indica que seus produtos são competitivos.
Durante a entrevista técnica, James Luan, VP of Engineering da Zilliz, me disse que a empresa pretende ser a número 1 na área de bancos de dados vetoriais, nenhuma outra opção é aceitável. Hoje em dia, bancos de dados vetoriais são um campo em evolução muito rápida, e isso implica um nível muito alto de competitividade. Essa frase específica do James foi o que, no fim, me fez entrar na Zilliz, porque combina com minha forma de pensar e é muito familiar e natural para mim. Além disso, fiquei curioso, porque o campo de bancos de dados vetoriais introduz desafios adicionais às aplicações tradicionais de busca por similaridade, como a necessidade de modificar os dados ou de incluir metadados adicionais em cada amostra.
Continuarei contribuindo com minhas melhorias para o Milvus OSS e planejo me envolver cada vez mais em tornar os produtos da Zilliz os melhores possíveis. Talvez eu consiga aplicar meu conhecimento sobre o uso de ANNS para previsão de séries temporais em algum momento.
Continue lendo
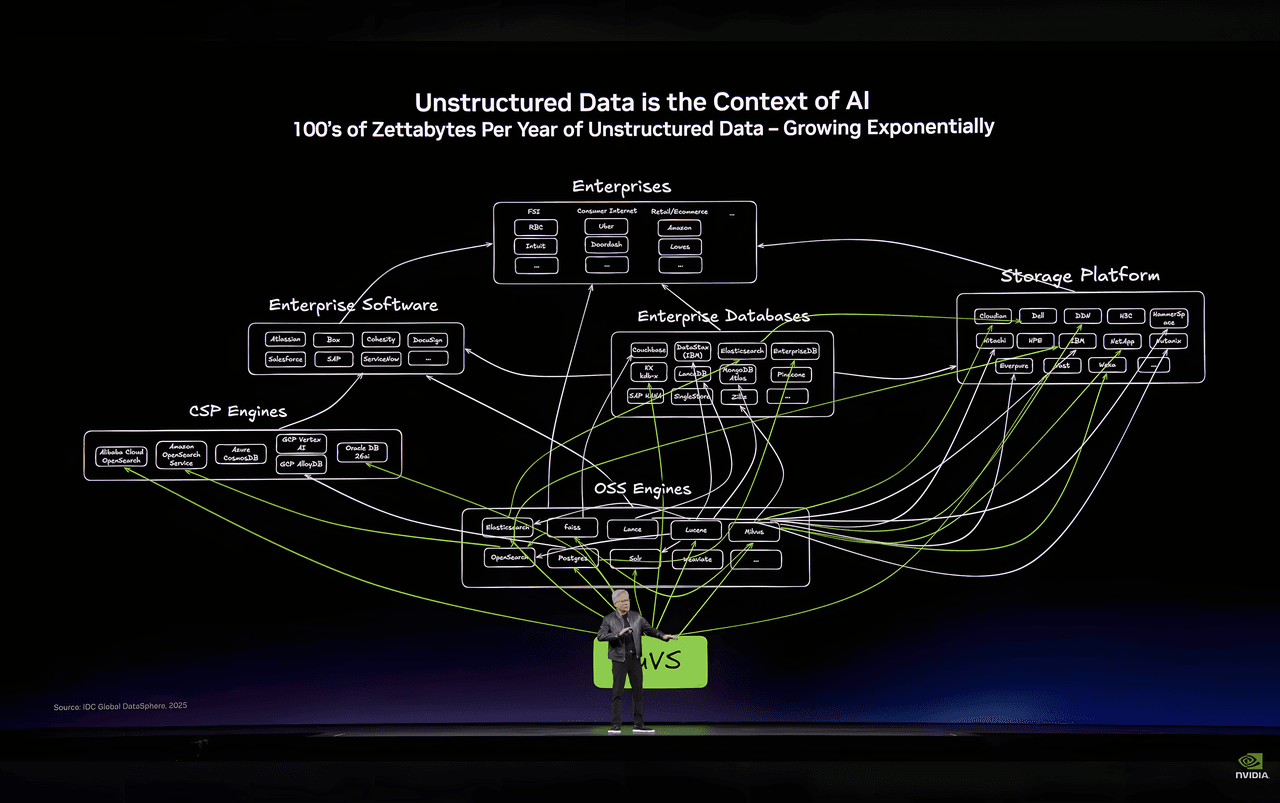
How Zilliz Ended Up at the Center of NVIDIA’s Unstructured Data Story at GTC 2026
If unstructured data is the context of AI, then the ceiling of AI applications will be set not just by models, but by how mature the infrastructure for unstructured data becomes.
Why Not All VectorDBs Are Agent-Ready
Explore why choosing the right vector database is critical for scaling AI agents, and why traditional solutions fall short in production.
What is the K-Nearest Neighbors (KNN) Algorithm in Machine Learning?
KNN is a supervised machine learning technique and algorithm for classification and regression. This post is the ultimate guide to KNN.