Consensus costruisce una ricerca accademica agentica su oltre 400 milioni di fonti accademiche con Zilliz Cloud
400M+
Fonti accademiche ricercabili
~45 ms
Latenza di recupero denso P99 in produzione
14% in più
precisione nei risultati di ricerca dopo aver aggiunto la ricerca semantica
4× più grande
vettori per appena 2,5 volte la dimensione del cluster, senza alcuna penalità di latenza
1 giorno → 1 ora
Re-indicizzazione completa dell'intera collezione di vettori da 400M+ tramite import bulk giornaliero
Il nostro compito è rendere trovabile la migliore ricerca per chiunque utilizzi Consensus. Zilliz Cloud offre al nostro agente di ricerca un recupero semantico rapido e di alta qualità, ampliando direttamente le evidenze a cui può accedere.
Christian Salem
Informazioni su Consensus
Consensus sta costruendo il sistema operativo per la ricerca scientifica: una piattaforma agente utilizzata da oltre 10 milioni di ricercatori, studenti e clinici in più di 12.500 università per vagliare articoli, sintetizzare evidenze e automatizzare le parti noiose della ricerca, così da poter tornare alla vera scienza. Consensus ha gestito più di 150 milioni di domande di ricerca fino ad oggi e ha raccolto 45 milioni di dollari per accelerare i prossimi 100 milioni di ricercatori nel mondo.
 Consensus插图1.png
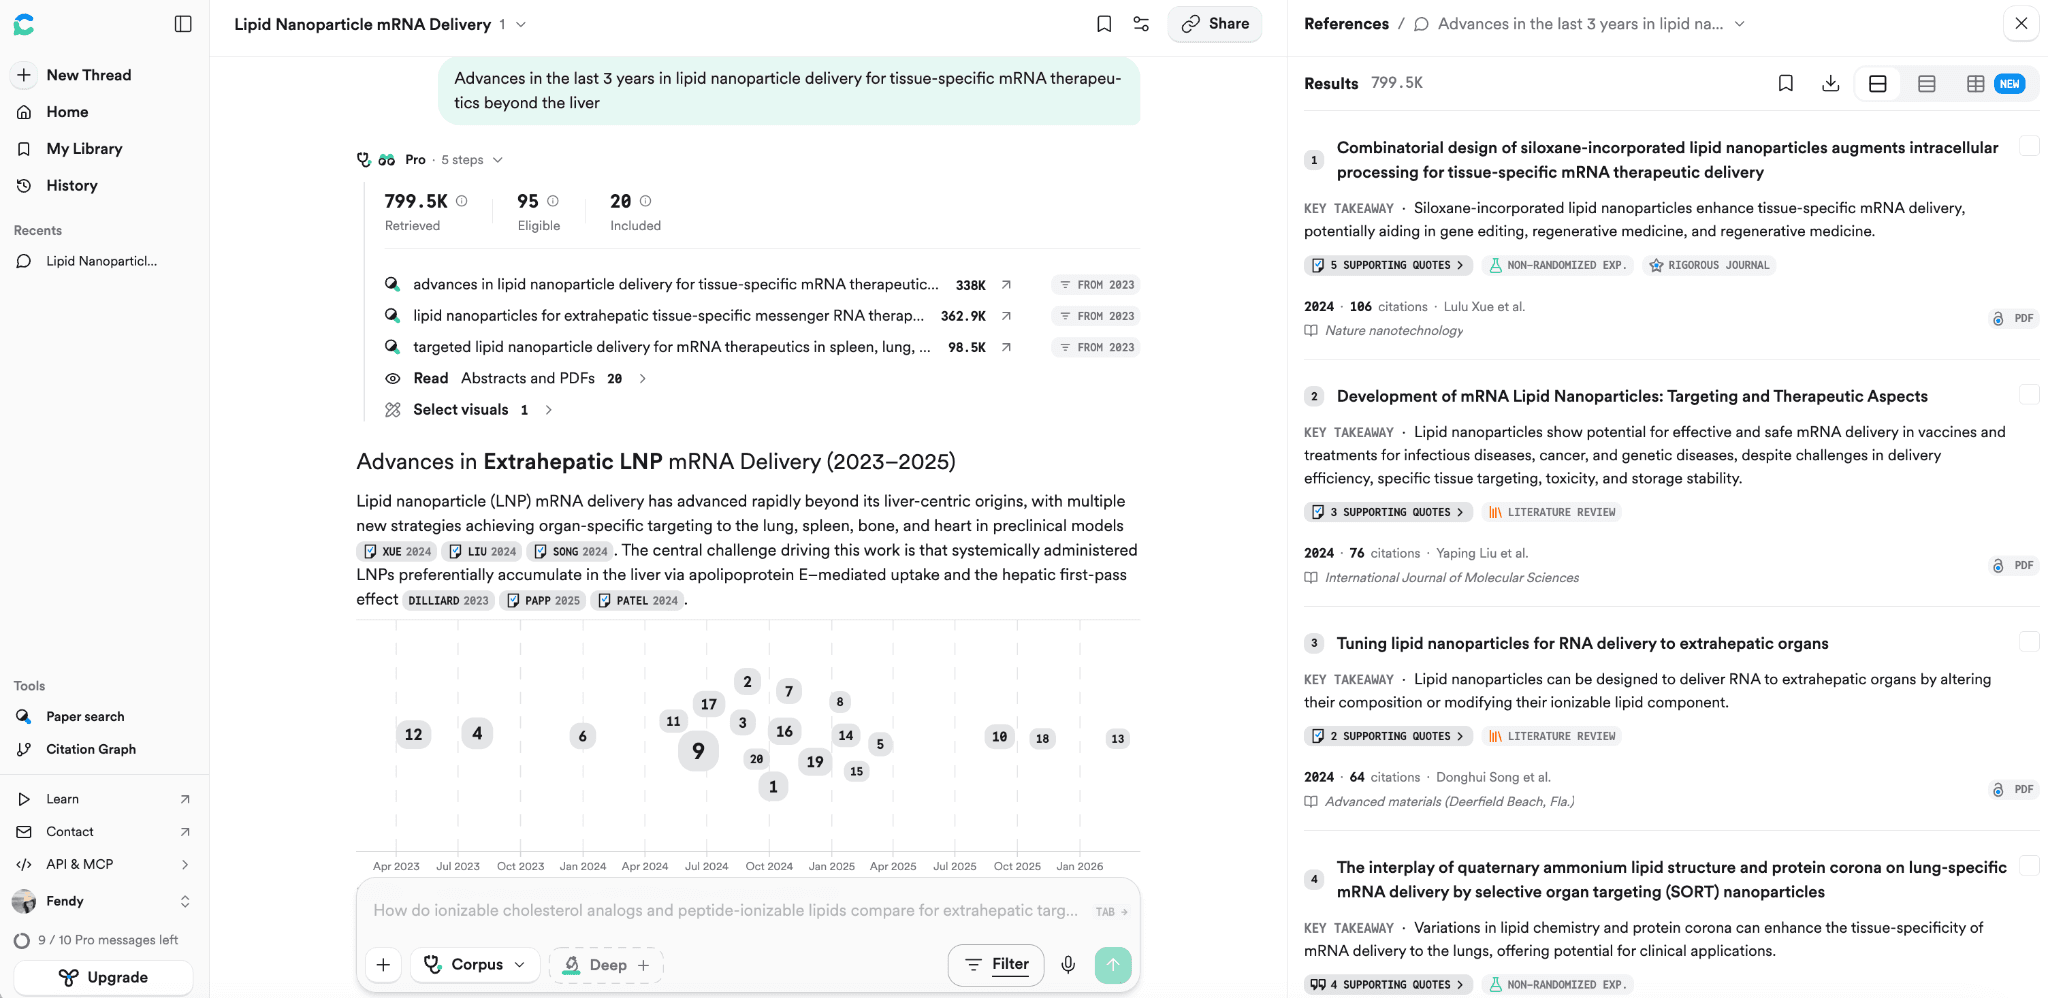
Le fondamenta della piattaforma sono una ricerca agentica di livello mondiale su oltre 400 milioni di fonti accademiche. Consensus non risponde mai basandosi sulla conoscenza del modello di intelligenza artificiale; ogni affermazione deve invece risalire a un articolo reale e recuperato, e l'agente di ricerca può effettuare più chiamate di recupero per rispondere a una singola domanda. Il prodotto è valido tanto quanto gli articoli che trova, il che rende il recupero il cuore di Consensus. Zilliz Cloud alimenta uno dei suoi componenti più importanti: la ricerca semantica che capisce cosa sta realmente chiedendo un ricercatore e porta in superficie gli studi che rispondono alla domanda.
La sfida
Il motore di recupero di Consensus in precedenza utilizzava due metodi di recupero: ricerca sparsa e ricerca per parole chiave BM25. Gestivano bene la maggior parte delle query. Ma l'asticella si stava alzando: Consensus stava trasformando la sua revisione della letteratura in un'architettura agentica, in cui una singola domanda può trasformarsi in molte chiamate di recupero, quindi il recupero doveva trovare gli articoli giusti e restituirli rapidamente, a ogni chiamata. La ricerca per parole chiave e quella sparsa non trovano articoli che dicono la stessa cosa ma con terminologia diversa. I ricercatori si imbattono in questo problema continuamente, perché l'articolo che risponde a una domanda spesso proviene da un campo vicino che usa i propri termini per lo stesso concetto. La ricerca a vettori densi è fondamentale per colmare questo divario, quindi il team l'ha testata prima in Elasticsearch e ha incontrato altri tre problemi.
- La qualità del recupero è diminuita con centinaia di milioni di vettori. Per far entrare così tanti vettori densi, il team ha dovuto comprimerli con la quantizzazione binaria, e la compressione è costata una perdita misurabile in termini di qualità del ranking. Per un prodotto di ricerca, è un compromesso sbagliato.
- La re-indicizzazione dell'intera raccolta richiedeva più di 24 ore. Le nuove ricerche aspettavano un giorno o più per diventare ricercabili, e ogni modello di embedding candidato costava un intero giorno di valutazione in produzione, rallentando l'adozione di modelli migliori da parte del team.
- Vettori più grandi significavano un costo di archiviazione molto più alto. Con centinaia di milioni di vettori, ogni aumento della dimensione o della copertura dei vettori viene pagato sull'intera raccolta, quindi il team ha mantenuto i propri vettori più piccoli di quanto desiderasse.
Il team ha cercato un motore appositamente progettato per il recupero semantico: alta qualità del ranking, aggiornamenti rapidi della raccolta, costi sostenibili su larga scala e un'esperienza di produzione gestita senza dovervi dedicare personale.
Perché Zilliz Cloud
Consensus ha condotto un vero confronto tra quattro opzioni: ricerca a vettori densi in Elasticsearch, che aveva già utilizzato; FAISS, una libreria vettoriale open-source autogestita di cui aveva realizzato un prototipo; Pinecone; e Zilliz Cloud. Zilliz Cloud ha vinto su quattro fronti.
- Risultati migliori senza comprimere i vettori. Nei test interni del team, Zilliz Cloud ha fornito risultati di retrieval più precisi su scala di centinaia di milioni, mantenendo un recall elevato, senza la compressione che in precedenza era costata in termini di qualità.
- Ricostruzione completa della collection in circa un'ora, rispetto a più di un giorno. Un'importazione bulk giornaliera dell'intera collection trasforma una ricostruzione completa da progetto speciale a operazione notturna. Questo consente anche un'iterazione molto più rapida quando si testano nuovi modelli di embedding.
- Costo di archiviazione inferiore a parità di traffico e numero di vettori. Il risparmio ha permesso di utilizzare vettori 4 volte più grandi e con un costo fino a 4 volte inferiore, con una rilevanza notevolmente più alta.
- Un servizio gestito, con un'esperienza sviluppatore che è piaciuta al team. Consensus ha realizzato un prototipo su FAISS e lo ha trovato tecnicamente valido, ma gestirlo in produzione avrebbe significato assumersi un overhead di orchestrazione e operatività che il team non aveva alcun interesse a sostenere. Il team ha inoltre trovato l'SDK di Zilliz Cloud ben documentato e piacevole con cui sviluppare, con una console semplice e intuitiva per le operazioni quotidiane sulla collection.
La soluzione
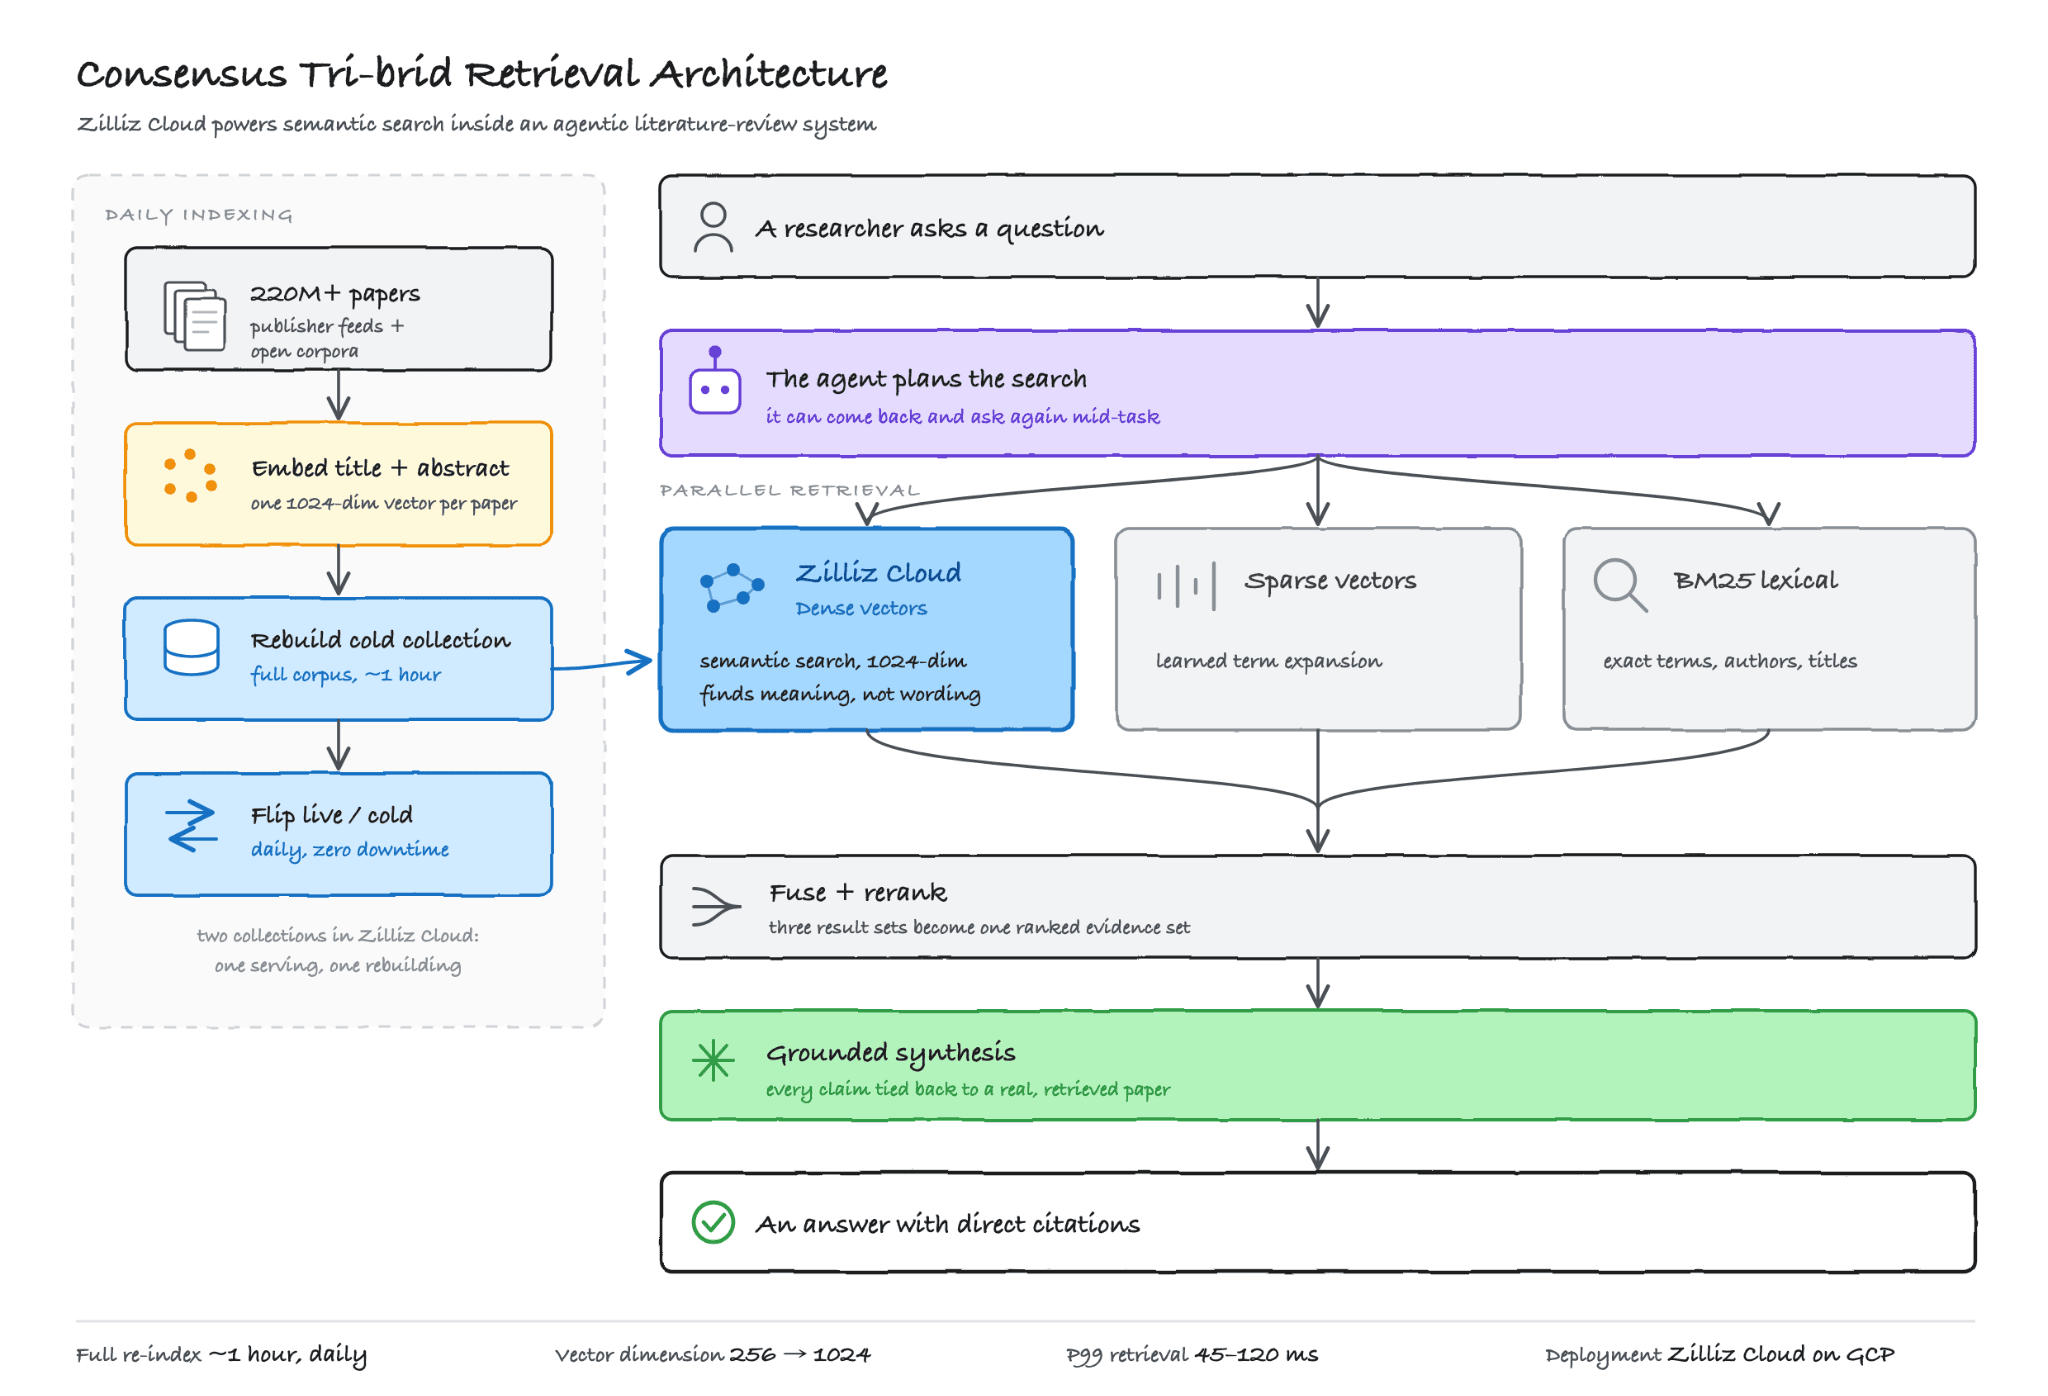
Consensus risponde a una domanda di ricerca recuperando gli articoli giusti o porzioni di articoli e sintetizzando una risposta a partire da essi, con ogni affermazione citata a una pubblicazione reale. Tre percorsi di retrieval vengono eseguiti in parallelo per trovare questi articoli, un'architettura che il team chiama tri-brid search, e Zilliz Cloud alimenta il livello di ricerca semantica: abbina una domanda a un articolo in base al significato piuttosto che alle parole utilizzate, e trova gli articoli che gli altri percorsi non individuano. È in esecuzione su Google Cloud insieme al resto dello stack.
 Concensus插图2.png
Al momento della query, l'agente pianifica la ricerca e chiama il retrieval come strumento. I percorsi vengono eseguiti in parallelo, i loro risultati vengono fusi e riordinati in un unico insieme di prove, e il modello scrive la risposta, collegando ogni affermazione a un articolo recuperato. Questo è il meccanismo alla base dell'agente di revisione della letteratura e del Consensus Meter, che valuta le prove pubblicate a favore e contro un'affermazione.
Tre scelte di design rendono possibile tutto questo.
Una coppia live/cold di collection in Zilliz Cloud, ricostruita da zero ogni giorno.
Il modo consueto per mantenere aggiornato un indice di queste dimensioni è aggiornarlo in place: rilevare cosa è cambiato, scrivere i nuovi vettori, eliminare i vecchi e tenere in ordine la contabilità. Consensus salta tutto questo. Mantiene due copie della collection in Zilliz Cloud, 400M+ di vettori in totale, una che serve le query e una inattiva, e ogni giorno ricostruisce da zero la copia inattiva tramite importazione bulk e la attiva.
Questo è un design sensato solo se una ricostruzione completa è abbastanza veloce da essere eseguita quotidianamente e l'archiviazione è abbastanza economica da contenere una seconda copia. Sul sistema precedente, nessuna delle due condizioni era vera. Su Zilliz Cloud, entrambe lo sono: l'intera collection viene importata, indicizzata e resa operativa in circa un'ora, con un costo di archiviazione inferiore. Quindi vince il design più semplice: nulla viene mai scritto nella collection che serve le query, non c'è alcun backlog da riconciliare, e un nuovo modello di embedding è semplicemente la stessa ricostruzione con vettori diversi. Il corpus è sempre aggiornato, garantendo ai ricercatori l'accesso sempre alle pubblicazioni più recenti.
"Quello che il team ha scoperto con Zilliz è che possiamo praticamente reimportare l'intera collection da zero, perché è così veloce. Abbiamo due copie dell'indice; importiamo l'intera cosa in un'ora, e poi giriamo l'interruttore. Possiamo farlo praticamente ogni giorno a questo punto. Questo ha anche notevolmente favorito la sperimentazione, poiché non c'è esitazione a provare nuove idee." — Heath Hohwald, Tech Leader e Search Manager, Consensus
Ogni fonte viene incorporata a partire dal titolo e dall'abstract in un singolo vettore. Il team ha iniziato con 256 dimensioni, supponendo che costi e latenza sarebbero cresciuti in modo proporzionale alla dimensione del vettore. Su Zilliz Cloud, quadruplicare la dimensione da 256 a 1.024 ha richiesto all'incirca 2.5× la dimensione del cluster, non i 4× che il team si aspettava, con pochissima latenza aggiuntiva. Nel benchmark interno del team, gli embedding a 1.024 dimensioni hanno prodotto un aumento del 27% nella qualità degli articoli trovati rispetto al modello più piccolo, quindi Consensus ha adottato 1.024.
Ricerca semantica come strumento chiamato direttamente dall'agente.
Zilliz Cloud è esposto all'agente di revisione della letteratura come strumento richiamabile, anziché nascosto dietro un singolo passaggio di recupero. L'agente può riformulare la domanda, cercare da più angolazioni e tornare a chiedere altro dopo aver letto ciò che ha trovato, quindi un singolo compito può comportare molte chiamate. Il tool calling funziona solo se ogni chiamata è veloce e precisa, perché una ricerca lenta o imprecisa viene moltiplicata da ogni chiamata aggiuntiva che l'agente effettua. Con ~45 ms P99 su oltre 400M+ vettori, la ricerca semantica è abbastanza veloce e precisa da essere affidata all'agente come strumento, così può andare a scovare gli ultimi articoli difficili da trovare che una singola query si lascerebbe sfuggire.
Risultati e Vantaggi
- Fino a 4× di costo di archiviazione inferiore, e i risparmi sono stati investiti in una ricerca migliore. L'archiviazione costa meno a parità di traffico e numero di vettori, creando il margine che il team ha poi speso in qualità.
- Precisione superiore del 14% nei risultati di ricerca dopo l'aggiunta della ricerca semantica, misurata sul benchmark interno di Consensus. Il miglioramento è più marcato per gli articoli che rispondono a una domanda con parole mai usate dal ricercatore, che il vecchio stack avrebbe perso.
- Recupero P99 a ~45 ms su oltre 400M+ vettori, un terzo dell'obiettivo P90 di 150 ms che il team aveva fissato per Zilliz Cloud. Abbastanza veloce perché l'agente di ricerca possa cercare, riflettere e iterare più volte in una singola richiesta, invece di avere un solo tentativo e talvolta perdersi risultati critici.
- Dimensioni vettoriali 4x più grandi (256 → 1,024) sono costate solo 2.5× il cluster su Zilliz Cloud, circa il 40% in meno rispetto alla scalatura lineare, senza penalità di latenza. Nel benchmark interno di Consensus, gli embedding più grandi hanno prodotto un aumento del 27% nella qualità degli articoli trovati.
- Ricostruzione completa dell'intera collezione: da oltre 24 ore a circa 1 ora, come import bulk giornaliero. Consensus ora ricostruisce e sostituisce l'intera collezione ogni giorno, senza interruzioni del servizio. Le nuove ricerche sono ricercabili lo stesso giorno in cui arrivano.
- Il ciclo di iterazione diventa più veloce. Embedding più grandi, nuovi modelli e nuove strategie di recupero non devono più essere valutati contro una ricostruzione di un giorno intero prima che qualcuno possa vedere se funzionano.
Prossimi Passi
Ogni direzione verso cui Consensus sta andando mette più peso su Zilliz Cloud. Esporre la ricerca semantica più ampiamente attraverso il framework agentico significa più chiamate di recupero per attività e più traffico sulla collezione densa. Nuovi modelli di embedding continueranno a essere rilasciati con la cadenza giornaliera resa possibile dalla ricostruzione in un'ora. Il filtraggio dei metadati, attualmente gestito nel livello applicativo, è un candidato per essere spostato su Zilliz Cloud.
L'opportunità più grande è sfruttare ulteriormente il contenuto full-text. Consensus detiene contenuti full-text autorizzati grazie alle sue partnership con gli editori, e portare questa profondità nella collezione densa di Zilliz è un passo naturale: indicizzare il corpo di ogni articolo anziché il titolo e l'abstract moltiplicherebbe la collezione diverse volte e offrirebbe ai ricercatori una corrispondenza molto più granulare.
"Consensus sta facendo qualcosa di davvero difficile: rendere la letteratura scientifica mondiale ricercabile per significato, per un agente che può interrogare lo stesso corpus in una dozzina di modi diversi in un singolo compito. Siamo orgogliosi che Zilliz Cloud sia la base di recupero dietro tutto questo, e siamo entusiasti di continuare a costruire insieme mentre la ricerca agentica cresce." — James Luan, CTO di Zilliz
Costruisci AI Agentica con Zilliz Cloud
I sistemi agentici pongono nuove pressioni sul recupero: una singola richiesta utente può diventare diverse ricerche semantiche, riformulazioni e passaggi di raccolta di evidenze. Che tu stia scalando la RAG o costruendo una ricerca agentica, Zilliz Cloud ti offre la stessa base di recupero che alimenta Consensus.
Inizia gratuitamente con Zilliz Cloud, oppure parla direttamente con il nostro team.
"Una delle vittorie più grandi che abbiamo visto è una migliore gestione delle query pertinenti a livello semantico ma non testuale. Anche le query più lunghe e conversazionali sono migliorate drasticamente."
Heath Hohwald