Consensus développe une recherche académique agentique parcourant 400M+ sources savantes avec Zilliz Cloud
400M+
Sources académiques consultables
~45 ms
Latence de récupération dense P99 en production
14% plus élevé
précision dans les résultats de recherche après l'ajout de la recherche sémantique
4 fois plus grand
des vecteurs pour seulement 2,5× la taille du cluster, sans pénalité de latence
1 jour → 1 heure
Réindexation complète de l'ensemble de la collection de plus de 400 millions de vecteurs par import en masse quotidien
« Notre mission est de rendre les meilleures recherches accessibles à tous ceux qui utilisent Consensus. Zilliz Cloud offre à notre agent de recherche une récupération sémantique rapide et de haute qualité, élargissant directement le champ des preuves auxquelles il peut accéder. »
Christian Salem
À propos de Consensus
Consensus construit le système d'exploitation de la recherche scientifique : une plateforme d'agents utilisée par plus de 10 millions de chercheurs, étudiants et cliniciens dans plus de 12 500 universités pour analyser des articles, synthétiser des preuves et automatiser les tâches fastidieuses de la recherche, afin qu'ils puissent se consacrer à la vraie science. Consensus a traité plus de 150 millions de questions de recherche à ce jour et a levé 45 millions de dollars pour accélérer les 100 prochains millions de chercheurs dans le monde.
 Consensus插图1.png
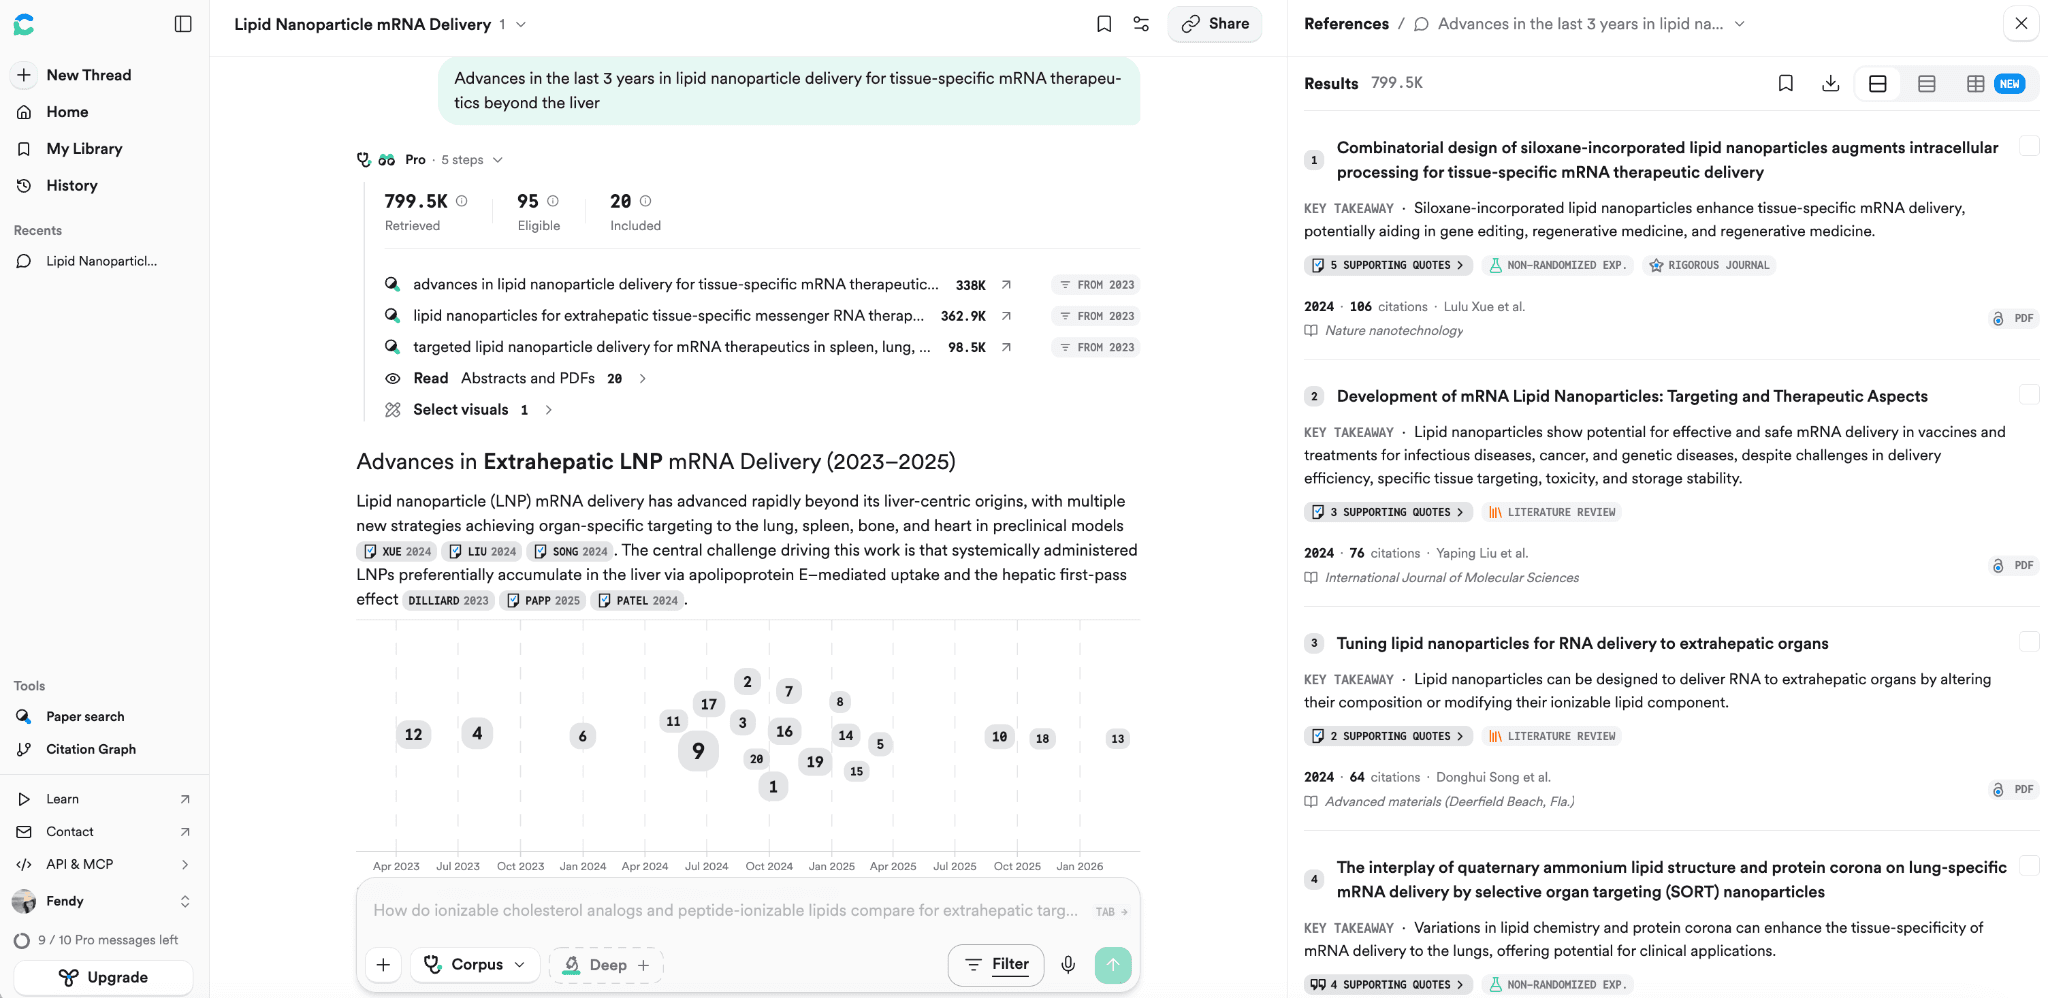
Le socle de la plateforme est une recherche agentique de classe mondiale couvrant plus de 400 millions de sources savantes. Consensus ne répond jamais à partir des connaissances du modèle d'IA ; au lieu de cela, chaque affirmation doit remonter à un article réel et retrouvé, et l'agent de recherche peut appeler la recherche de nombreuses fois pour répondre à une seule question. Le produit ne vaut que ce que valent les articles qu'il trouve, ce qui fait de la recherche le cœur de Consensus. Zilliz Cloud alimente l'un de ses composants les plus importants : la recherche sémantique qui comprend ce qu'un chercheur demande réellement et remonte les travaux qui y répondent.
Le défi
Le moteur de récupération de Consensus utilisait auparavant deux méthodes de récupération : la recherche par mots-clés sparse et BM25. Elles traitaient bien la plupart des requêtes. Mais le niveau d'exigence montait : Consensus faisait évoluer sa revue de littérature vers une architecture agentique, où une seule question peut se transformer en de nombreux appels de récupération ; la récupération devait donc trouver les bons articles et les renvoyer rapidement, à chaque appel. La recherche par mots-clés et sparse passe à côté d'articles qui disent la même chose avec une terminologie différente. Les chercheurs le constatent constamment, car l'article qui répond à une question provient souvent d'un domaine voisin qui utilise ses propres termes pour la même idée. La recherche par vecteurs denses est essentielle pour combler cet écart ; l'équipe l'a donc d'abord testée dans Elasticsearch et a rencontré trois problèmes supplémentaires.
- La qualité de la récupération chutait à des centaines de millions de vecteurs. Pour faire tenir autant de vecteurs denses, l'équipe a dû les compresser avec une quantification binaire, et cette compression a coûté une part mesurable de la qualité de classement. Pour un produit de recherche, c'est le mauvais compromis.
- La réindexation de l'ensemble de la collection prenait plus de 24 heures. Les nouvelles recherches attendaient un jour ou plus avant de devenir consultables, et chaque modèle d'embedding candidat coûtait une journée entière d'évaluation en production, ce qui ralentissait l'adoption de meilleurs modèles par l'équipe.
- Agrandir les vecteurs signifiait une facture de stockage beaucoup plus lourde. À des centaines de millions de vecteurs, chaque augmentation de la taille ou de la couverture des vecteurs est payée sur l'ensemble de la collection ; l'équipe a donc conservé des vecteurs plus petits que ce qu'elle souhaitait.
Pourquoi Zilliz Cloud
Consensus a organisé un véritable comparatif entre quatre options : la recherche par vecteurs denses dans Elasticsearch, qu'elle avait déjà utilisée ; FAISS, une bibliothèque vectorielle open-source auto-gérée qu'elle avait prototypée ; Pinecone ; et Zilliz Cloud. Zilliz Cloud l'a emporté sur quatre plans.
- De meilleurs résultats sans compression des vecteurs. Lors des tests internes de l'équipe, Zilliz Cloud a fourni des résultats de recherche plus précis à l'échelle de centaines de millions tout en maintenant un rappel élevé, sans la compression qui avait coûté de la qualité auparavant.
- Une reconstruction complète de la collection en environ une heure, contre plus d'une journée auparavant. Une importation massive quotidienne de l'ensemble de la collection transforme une reconstruction complète d'un projet spécial en une tâche nocturne. Cela permet également des itérations beaucoup plus rapides lors du test de nouveaux modèles d'embedding.
- Un coût de stockage inférieur pour le même trafic et le même nombre de vecteurs. Les économies réalisées ont permis d'utiliser des vecteurs 4 fois plus volumineux pour un coût jusqu'à 4 fois moindre, ce qui se traduit par une pertinence nettement supérieure.
- Un service managé, avec une expérience développeur appréciée par l'équipe. Consensus a fait un prototype sur FAISS et l'a jugé techniquement compétent, mais l'exploiter en production aurait impliqué d'assumer une charge d'orchestration et d'exploitation que l'équipe ne souhaitait pas porter. L'équipe a également trouvé le SDK Zilliz Cloud bien documenté et agréable à utiliser, avec une console simple pour les opérations quotidiennes sur les collections.
La solution
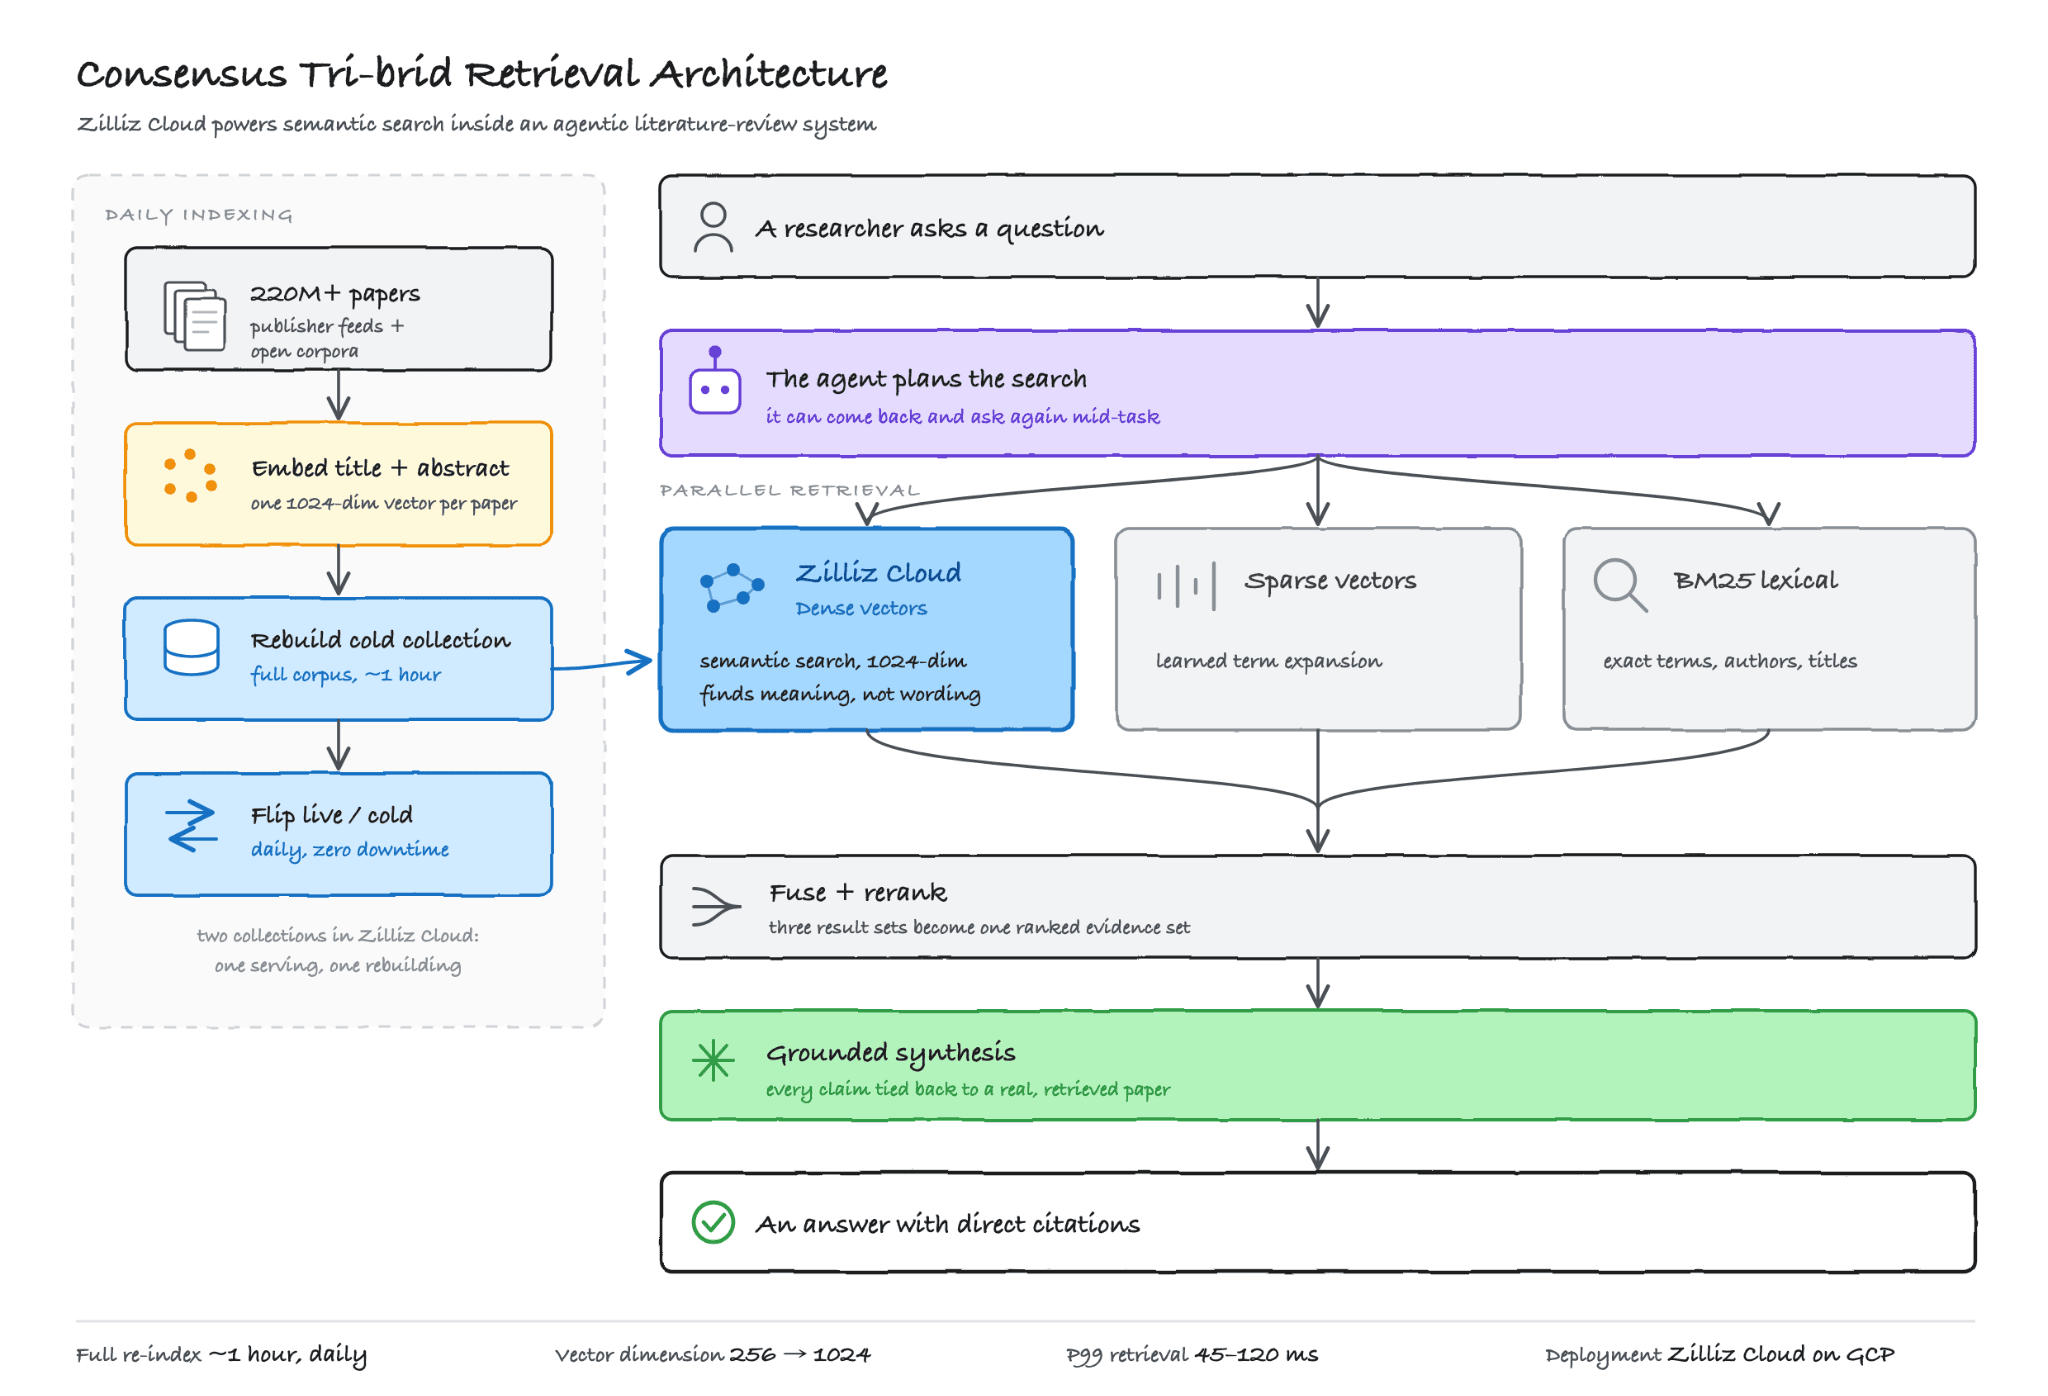
Consensus répond à une question de recherche en récupérant les bons articles ou des extraits d'articles et en synthétisant une réponse à partir de ceux-ci, chaque affirmation étant rattachée à une publication réelle. Trois chemins de recherche s'exécutent en parallèle pour trouver ces articles, une architecture que l'équipe appelle la recherche tri-brid, et Zilliz Cloud alimente la couche de recherche sémantique : faire correspondre une question à un article selon son sens plutôt que selon les mots utilisés, et trouver les articles que les autres chemins manquent. Elle s'exécute sur Google Cloud aux côtés du reste de la pile.
 Concensus插图2.png
Au moment de la requête, l'agent planifie la recherche et appelle la récupération comme outil. Les chemins s'exécutent simultanément, leurs résultats fusionnent et sont reclassés en un ensemble de preuves unique, puis le modèle rédige la réponse, reliant chaque affirmation à un article récupéré. C'est la mécanique qui sous-tend l'agent de revue de littérature et le Consensus Meter, qui pèse les preuves publiées pour et contre une affirmation.
Trois choix de conception rendent cela possible.
Une paire de collections live/cold dans Zilliz Cloud, reconstruite de zéro chaque jour.
La méthode habituelle pour maintenir un index de cette taille à jour consiste à le mettre à jour sur place : détecter ce qui a changé, écrire les nouveaux vecteurs, supprimer les anciens et tenir une comptabilité rigoureuse. Consensus ignore tout cela. Il conserve deux copies de la collection dans Zilliz Cloud, 400M+ de vecteurs au total, l'une servant les requêtes et l'autre inactive, et chaque jour il reconstruit la copie inactive à partir de zéro par importation massive puis la bascule en production.
Cela n'est un choix de conception sensé que si une reconstruction complète est assez rapide pour être effectuée quotidiennement et que le stockage est assez bon marché pour conserver une seconde copie. Sur le système précédent, aucune de ces conditions n'était vraie. Sur Zilliz Cloud, les deux le sont : toute la collection est importée, indexée et prête à être utilisée en environ une heure, à un coût de stockage inférieur. Le choix le plus simple l'emporte donc : rien n'est jamais écrit dans la collection servant les requêtes, aucun arriéré à réconcilier, et un nouveau modèle d'embedding n'est que la même reconstruction avec des vecteurs différents. Le corpus est toujours à jour, garantissant aux chercheurs un accès permanent aux toutes dernières publications.
"Ce que l'équipe a découvert avec Zilliz, c'est que nous pouvons essentiellement ré-ingérer toute la collection à partir de zéro, tellement c'est rapide. Nous avons deux copies de l'index ; nous ingérons le tout en une heure, puis nous actionnons l'interrupteur. Nous pouvons le faire quotidiennement à ce stade. Cela a également grandement facilité l'expérimentation, car il n'y a aucune hésitation à essayer de nouvelles idées." — Heath Hohwald, responsable technique et responsable de la recherche, Consensus
Un vecteur de dimension 1 024 par source scientifique.
Chaque source est intégrée à partir de son titre et de son résumé en un seul vecteur. L'équipe a commencé avec 256 dimensions, en supposant que le coût et la latence augmenteraient proportionnellement à la taille du vecteur. Sur Zilliz Cloud, quadrupler la dimension de 256 à 1 024 a nécessité environ 2,5× la taille du cluster, et non les 4× auxquels l'équipe s'attendait, avec très peu de latence ajoutée. Sur le benchmark interne de l'équipe, les embeddings en 1 024 dimensions ont offert une augmentation de 27 % de la qualité des articles trouvés par rapport au modèle plus petit, si bien que Consensus a retenu la dimension 1 024.
La recherche sémantique comme outil appelé directement par l'agent.
Zilliz Cloud est exposé à l'agent de revue de littérature comme un outil appelable plutôt que caché derrière une seule étape de récupération. L'agent peut reformuler la question, chercher sous plusieurs angles, puis revenir chercher plus après avoir lu ce qu'il a trouvé ; une tâche peut donc impliquer de nombreux appels. Un tel appel d'outil ne fonctionne que si chaque appel est rapide et précis, car une recherche lente ou imprécise est multipliée par chaque appel supplémentaire effectué par l'agent. À ~45 ms P99 sur 400M+ vecteurs, la recherche sémantique est assez rapide et précise pour être confiée à l'agent comme outil, lui permettant de débusquer les derniers articles difficiles à trouver qu'une seule requête manquerait.
Résultats et avantages
- Jusqu'à 4× de coût de stockage en moins, et les économies ont été investies dans une meilleure recherche. Le stockage coûte moins cher à trafic et nombre de vecteurs identiques, créant une marge de manœuvre que l'équipe a ensuite consacrée à la qualité.
- Précision 14 % plus élevée dans les résultats de recherche après l'ajout de la recherche sémantique, mesurée sur le benchmark interne de Consensus. Le gain est le plus fort sur les articles qui répondent à une question avec des mots que le chercheur n'a jamais utilisés, que la pile précédente aurait manqués.
- Récupération P99 à ~45 ms sur 400M+ vecteurs, soit un tiers de l'objectif P90 de 150 ms que l'équipe avait fixé pour Zilliz Cloud. Assez rapide pour que l'agent de recherche puisse chercher, réfléchir et itérer plusieurs fois dans une seule requête, au lieu d'avoir une seule tentative et de manquer parfois des résultats critiques.
- Dimensions vectorielles 4x plus grandes (256 → 1 024) n'ont coûté que 2,5× le cluster sur Zilliz Cloud, soit environ 40 % de moins qu'une mise à l'échelle linéaire, sans pénalité de latence. Sur le benchmark interne de Consensus, les embeddings plus grands ont offert une augmentation de 27 % de la qualité des articles trouvés.
- Une reconstruction complète de l'ensemble de la collection : 24 h+ → environ 1 heure, sous forme d'import en masse quotidien. Consensus reconstruit et remplace désormais l'ensemble de la collection chaque jour, sans interruption du service. Les nouvelles recherches sont consultables le jour même de leur arrivée.
- La boucle d'itération s'accélère. Des embeddings plus grands, de nouveaux modèles et de nouvelles stratégies de récupération n'ont plus à être mis en balance avec une reconstruction d'une journée avant que quiconque puisse voir s'ils sont utiles.
Et ensuite
Chaque direction que prend Consensus met davantage l'accent sur Zilliz Cloud. Exposer la recherche sémantique plus largement via le cadre agentique signifie davantage d'appels de récupération par tâche, et plus de trafic vers la collection dense. De nouveaux modèles d'embedding continueront d'être déployés au rythme quotidien rendu possible par la reconstruction d'une heure. Le filtrage par métadonnées, actuellement géré dans la couche applicative, est un candidat pour être déplacé vers Zilliz Cloud.
La plus grande opportunité est d'exploiter davantage le contenu en texte intégral. Consensus détient du contenu en texte intégral sous licence grâce à ses partenariats avec les éditeurs, et intégrer cette profondeur dans la collection dense de Zilliz est une prochaine étape naturelle : indexer le corps de chaque article plutôt que son titre et son résumé multiplierait la collection plusieurs fois et offrirait aux chercheurs une correspondance bien plus fine.
« Consensus fait quelque chose de vraiment difficile : rendre la littérature scientifique mondiale interrogeable par le sens, pour un agent qui peut interroger le même corpus d'une douzaine de manières différentes dans une seule tâche. Nous sommes fiers que Zilliz Cloud soit le socle de recherche qui la sous-tend, et nous sommes ravis de continuer à construire ensemble à mesure que la recherche agentique prend de l'ampleur. » — James Luan, CTO de Zilliz
Construire une IA agentique avec Zilliz Cloud
Les systèmes agentiques exercent une nouvelle pression sur la récupération : une seule requête utilisateur peut se transformer en plusieurs recherches sémantiques, reformulations et passages de collecte de preuves. Que vous mettiez un RAG à l'échelle ou que vous construisiez une recherche agentique, Zilliz Cloud vous offre le même socle de récupération qui alimente Consensus.
Commencez gratuitement avec Zilliz Cloud, ou parlez à notre équipe directement.
"L'un des plus grands gains que nous avons constatés est une meilleure gestion des requêtes pertinentes sur le plan sémantique mais pas textuel. Les requêtes plus longues et plus conversationnelles se sont également considérablement améliorées."
Heath Hohwald